경우의 수와 확률 문제는 계산보다 문제의 조건을 해석하는 단계에서 먼저 막히기 쉽다. 처음에는 Gemini에 문제와 풀이를 모두 맡겼지만, 설명과 달리 최종 계산 결과가 틀리는 경우가 잦았다. 특히 잘못된 결과를 확신에 찬 문장으로 제시해 그대로 사용하기 어려웠다.
이를 보완하기 위해 자연어 문제를 구조화된 데이터로 변환하고 풀이 과정을 시각화하는 학습용 앱을 만들었다. Gemini는 문제의 조건과 풀이 유형을 구조화하고, 실제 경우의 수와 확률 계산은 Python 조합론 엔진이 수행한다.
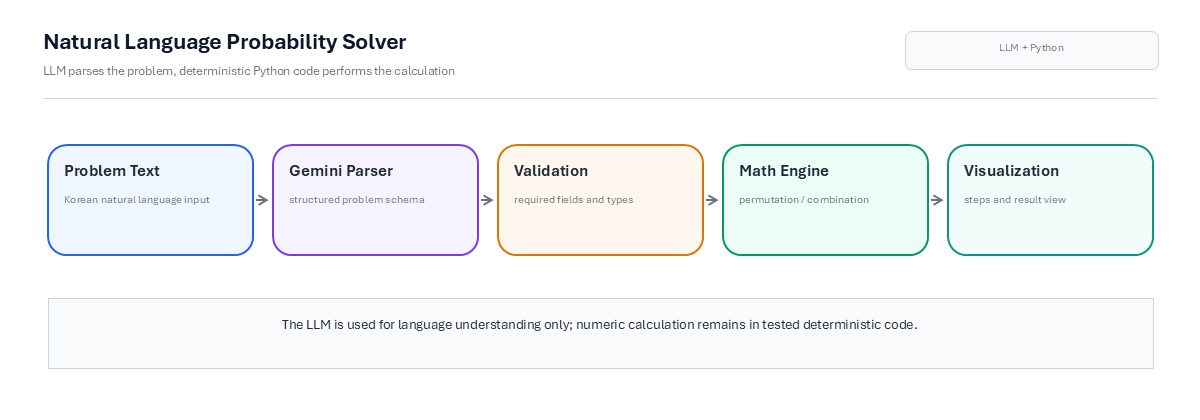
자연어 문제는 Gemini가 구조로 바꾸고, 숫자 계산은 검증된 파이썬 엔진이 담당한다.
지금 구조
FastAPI 백엔드와 React 프론트엔드로 구성했다. 문제를 입력하면 Gemini가 조건을 구조화하고, 백엔드가 이를 ViewModel로 변환해 화면에 표시한다. 현재는 학습용 사이드 프로젝트 범위로 개발하고 있다.
@app.post("/api/analyze")
async def analyze(problem: str):
    parsed = gemini.parse(problem)        # 자연어 → 구조 (LLM)
    result = math_utils.solve(parsed)     # 구조 → 답 (검증된 엔진)
    return to_viewmodel(parsed, result)
계산 엔진(math_utils.py)은 500여 줄의 일반 Python 코드로 작성했다. 순열·조합·중복 조합·조건부 확률을 구현하고 각 계산 경로를 테스트했다. LLM은 풀이 유형과 입력값을 구조화하고, 최종 계산은 이 엔진이 담당한다.
자연어 해석과 계산을 분리한 이유
초기 버전에서는 문제와 최종 답을 모두 Gemini에 요청했다. 간단한 문제는 풀었지만 숫자가 커지면 마지막 계산에서 오류가 발생했다. 풀이 과정이 자연스러워도 결과를 신뢰할 수 없다는 점이 더 큰 문제였다.
LLM은 순열·조합 등 풀이 유형과 입력값을 판단하고, 계산은 테스트 가능한 코드가 담당하도록 역할을 분리했다. 이후 계산 단계에서 발생하던 오류를 줄이고 각 계산 경로를 단위 테스트로 검증할 수 있었다.
DB는 SQLite를 기본으로 깔고 PostgreSQL, MySQL도 붙을 수 있게 추상화해뒀다. 인증도 환경 변수로 켜고 끌 수 있게 했다. 시연할 땐 끄고, 배포할 땐 켠다.
남은 해석 불확실성
조건이 명확한 문제는 안정적으로 처리하지만, 주어나 목적어가 생략된 한국어 문장에서는 구조화 결과가 흔들린다. 예를 들어 "다시 넣지 않는다"라는 조건이 문장 뒤에 나오면 앞선 조건과 분리해 해석하는 경우가 있다. 계산 오류는 테스트로 확인할 수 있지만, 문장 해석의 불확실성을 UI에서 어떻게 전달할지는 아직 해결하지 못했다.
이 작업을 통해 LLM은 계산기보다 자연어를 구조화하는 단계에 더 적합하다고 판단했다. 정확한 수치가 필요한 계산은 테스트할 수 있는 일반 코드에 맡기는 편이 안전하다.
참고