관리형 LLM 서비스 운영에서는 직접 확인하기 어려웠던 학습 과정과 자원 사용량을 살펴보기 위해 Gemma 4B 모델로 LoRA 파인튜닝을 진행했다. 목표는 정식 문장을 카카오톡 문체로 변환하는 소규모 실험이며, 모델 품질 경쟁보다 데이터 준비부터 평가까지 전체 학습 절차를 확인하는 데 초점을 맞췄다.
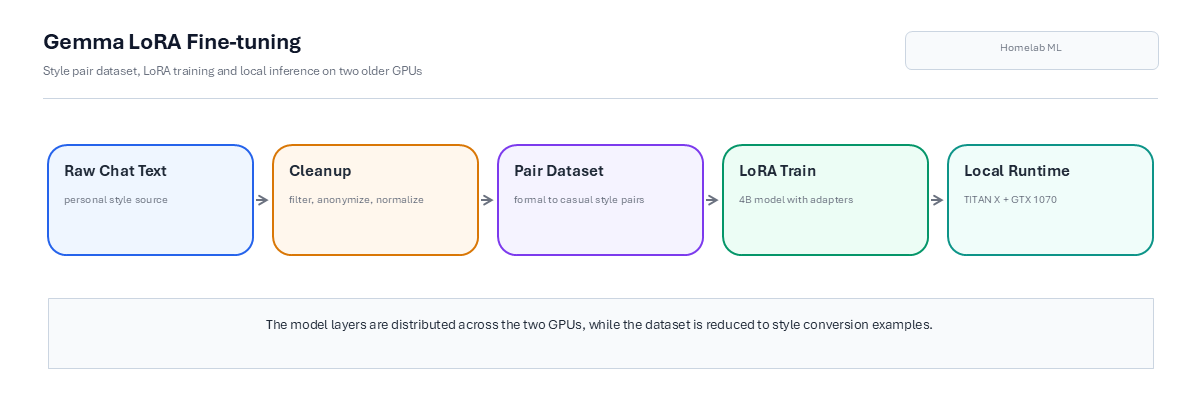
스타일 변환 쌍 데이터를 정제한 뒤 LoRA 학습을 수행하고, 오래된 GPU 두 장에 모델을 분산해 올렸다.
학습 데이터 구성과 정제
같은 내용을 정식체와 카카오톡 문체로 짝지은 데이터가 필요했다. 동일한 문장을 격식체, 반말, 이모티콘을 포함한 문체 등 16가지 형태로 제공하는 SmileStyle 데이터셋을 사용했다.
입력:  다음 문장을 카톡 말투로 바꿔줘: 안녕하세요. 식사는 하셨나요?
출력:  하잉ㅋㅋ 밥 먹음?? ✌
문체 변환 쌍과 함께, "친구와 카카오톡으로 대화하듯 답해 줘"와 같은 프롬프트에 해당 문체로 응답하는 에코 데이터를 구성했다. 공개 한국어 대화 데이터 약 2만 건도 추가했다. 개인정보가 포함된 항목을 제거한 뒤 사용했으며, 최종 학습 데이터는 약 23만 개 샘플이었다.
학습: GPU 두 장에 분산해 올렸다
집에 장착한 GPU가 TITAN X(12GB)와 1070(8GB)이다. 4B 모델을 LoRA로 붙여도 한 장에는 빠듯해서 device_map="auto"로 두 장에 레이어를 분산했다. 앞쪽 임베딩과 대부분 레이어는 TITAN X에, 뒤쪽은 1070에 배치했다.
model = AutoModelForCausalLM.from_pretrained(
    "google/gemma-4-E4B-it",
    device_map="auto",          # 두 장에 자동 분산
    torch_dtype=torch.bfloat16,
)
peft_config = LoraConfig(r=16, lora_alpha=32, lora_dropout=0.05)
# 유효 배치 32 (배치 1 × grad_accum 32), 시퀀스 256, LR 1e-4, 1 epoch
배치는 1로 두고 gradient accumulation 32로 유효 배치 32를 맞췄다. 시퀀스 길이는 256, 1 에폭이다. 오래된 카드 두 장이라 빠르진 않았다. 23만 샘플 한 바퀴 도는 데 이틀쯤 걸렸다.
평가 결과와 한계
500스텝마다 평가했고 checkpoint-2000에서 eval loss가 1.711로 가장 낮았다. 토큰 정확도는 61.3%였다. 절대적인 수치는 높지 않았지만 모델 크기와 학습 환경을 고려하면 실험 목적에는 충분했다.
이후 RTX 4070 Ti 한 장으로 다시 학습할 때는 8비트 양자화를 적용하고 시퀀스 길이를 512로 늘렸다. 4비트 QLoRA도 검토했지만, 8비트 구성이 단순하고 약 11GB의 VRAM 안에서 실행돼 그대로 사용했다.
실험에서 확인한 점
별도의 베이스라인과 정량 비교를 수행하지 않았으므로 개선 폭을 수치로 제시할 수는 없다. 일부 샘플에서는 문체 변화를 확인했지만, 대화가 길어지면 기본 모델의 문체가 다시 나타났다.
12GB와 8GB 메모리를 가진 구형 GPU 두 장으로도 4B 모델의 LoRA 학습이 가능하다는 점을 확인했다. 매니지드 서비스에서는 보기 어려웠던 학습 루프와 loss 변화를 직접 관찰한 것이 이 실험의 가장 큰 수확이었다.
이번 실험에서는 모델 학습보다 데이터 구성과 정제에 더 많은 시간이 들었다. 학습 결과를 해석할 때 모델 설정뿐 아니라 데이터 품질과 구성 과정을 함께 확인해야 했다.
참고