첫 컨테이너는 CUDA 런타임과 드라이버 버전이 맞지 않아 바로 종료됐다. 모델을 실행하기 전에 GPU 드라이버와 CUDA 호환성부터 확인해야 했다.
회사에서는 LLM 게이트웨이를 운영했지만 모델 추론 환경을 직접 구성할 기회는 적었다. 관리형 API 바깥의 GPU 메모리, 런타임과 모델 호환성을 확인하기 위해 보관 중이던 GPU 두 장으로 홈서버를 구성했다.
- TITAN X (Maxwell, 12GB)
- GTX 1070 (Pascal, 8GB)
Maxwell 세대인 TITAN X는 2015년에 출시된 제품이다. 최신 CUDA 기능에는 제약이 있지만 소형 모델 추론과 음성 처리 성능을 확인하기에는 사용할 수 있다고 판단했다. GPU 두 장과 전원공급장치 두 개를 오픈 벤치에 구성했다.
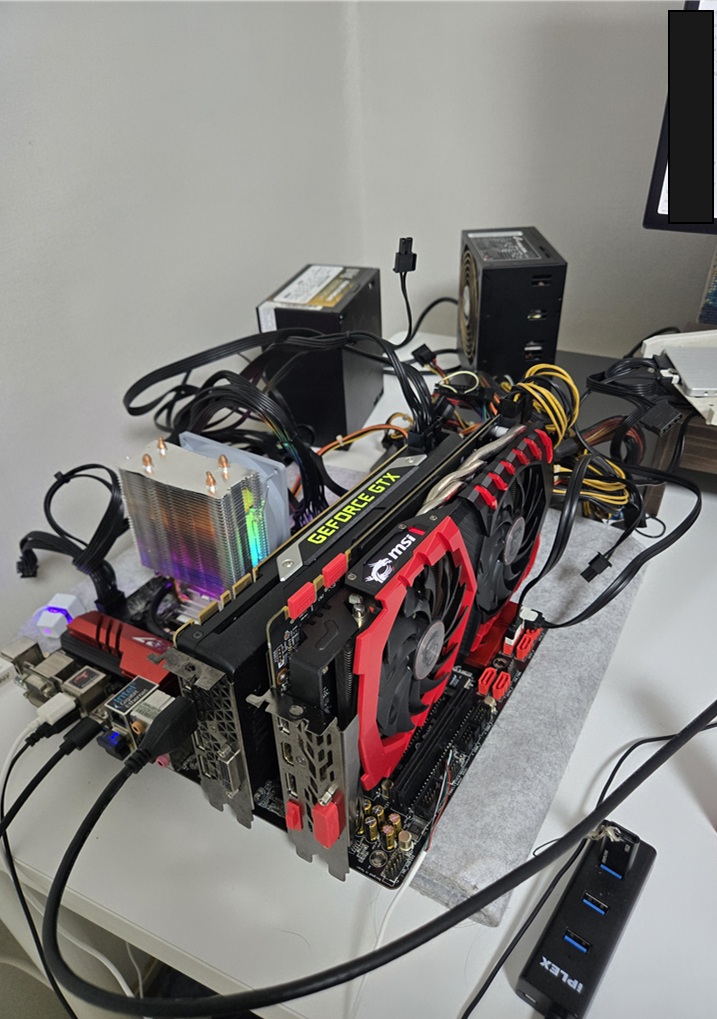
책상에 그대로 올린 두 장. 파워 두 개로 돌린다.
드라이버 설치 절차와 nouveau 비활성화 설정을 확인하는 데 LLM 도구를 활용했다. 제안된 명령과 대상 파일을 검토한 뒤 적용하고, 설치 결과와 GPU 인식 상태를 직접 확인했다.
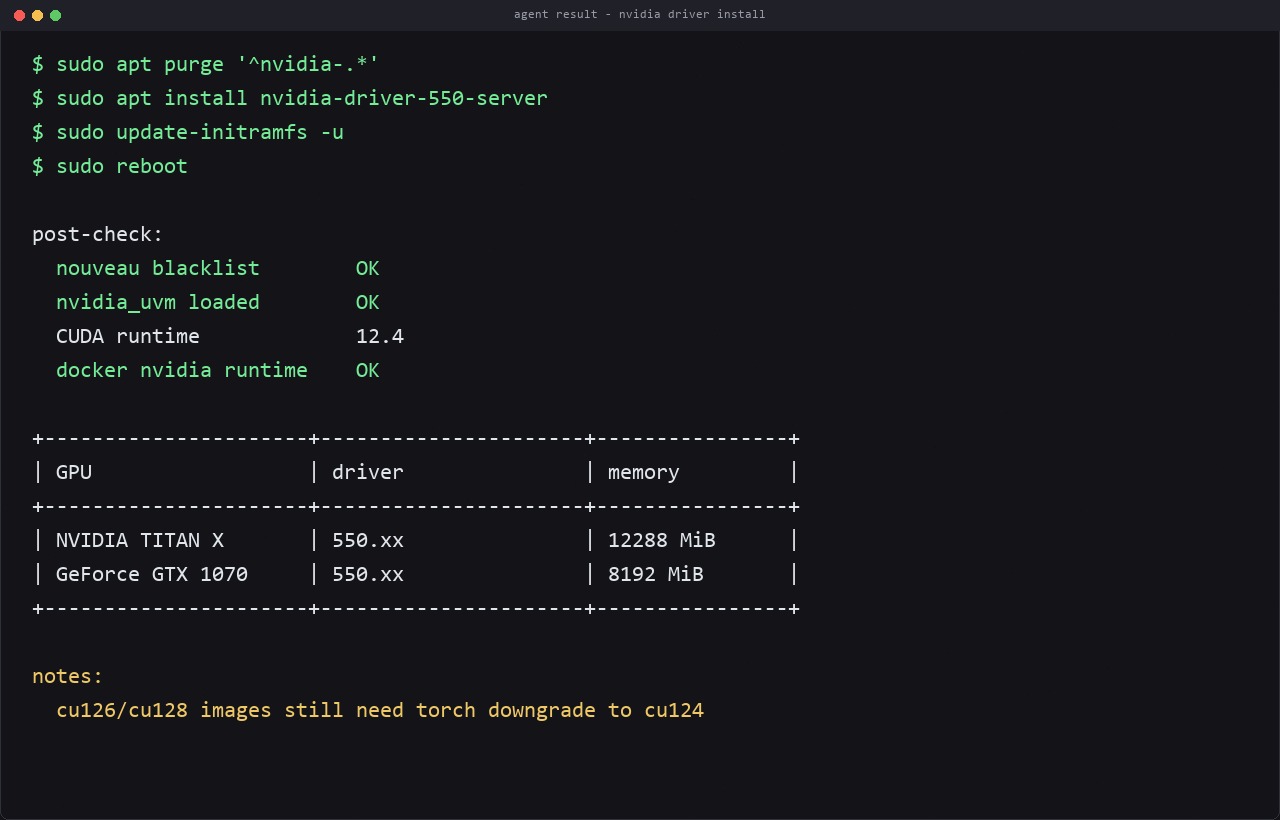
드라이버 설치 후 버전과 GPU 인식 상태를 확인한 결과.
다음 문제는 CUDA 버전이었다. 550 드라이버가 지원하는 CUDA는 12.4까지였지만 사용하려던 컨테이너 이미지는 주로 cu126 또는 cu128로 빌드돼 있었다. 그대로 실행하면 런타임 버전이 맞지 않아 컨테이너가 종료됐다. 이후 PyTorch 패키지를 cu124에 맞추는 작업이 기본 절차가 됐고, 같은 호환성 검토가 STT와 TTS 구성에서도 반복됐다.
목표는 한국어 음성을 텍스트로 변환하고, 모델의 답변을 다시 한국어 음성으로 재생하는 전 과정을 집 안의 장비에서 처리하는 것이었다. STT는 faster-whisper, 답변 생성은 Ollama, 음성 합성은 Edge TTS로 구성했다. 이후 음성 복제 기능을 추가하고 전체 서비스를 Open WebUI와 Podman으로 묶었다.
구형 GPU에서 최신 소프트웨어를 실행하려면 버전 호환성을 지속적으로 확인해야 했다. GPU 인식과 서버 기동을 마친 뒤 Ollama부터 서비스를 하나씩 추가했다.
참고