상용 배포에는 늘 같은 사전 작업이 따라붙었다. 배포할 서버 그룹으로 트래픽이 들어가지 않도록 L4(로드밸런서)에서 그 그룹을 빼는 일이다. 문제는 이걸 사람이 했다는 데 있었다. 엔지니어가 L4 콘솔에 직접 접속해 수동으로 서버를 내리고, 배포가 끝나면 다시 올렸다. 사람이 하니 실수가 났다. 절체되지 않은 서버에 배포하기도 하고, 엉뚱한 그룹을 내리기도 했다. 커뮤니케이션이 어긋나 장애로 이어질 확률도 높았다. 이 수동 작업을 코드로 옮긴 이야기다.
두 가지 방식을 PoC로 비교했다
L4를 자동 제어하는 방법은 크게 두 가지가 있었다. 둘 다 만들어서 테스트하고 비교했다.
(A) Health check 방식. 각 서버에 있는 health.html의 내용을 200 OK ↔ 503 DISABLED로 바꾸는 방식이다. L4의 health check monitor는 응답이 200 OK가 아니면 그 서버를 자동으로 제외한다. 구현이 단순하다.
(B) L4 API 방식. L4 장비가 제공하는 REST API를 직접 호출해 노드 상태를 제어하는 방식이다. 구현은 무겁지만 할 수 있는 게 많다.
테스트해 보니 장단점이 극명했다.
| 항목 | Health check 방식 | L4 API 방식 |
|---|---|---|
| 개발 공수 | 적음 (Jenkins job 하나) | 큼 (벤더별 API 통합 필요) |
| 외부(개발팀) 지원 | 필요 (특히 Spring Boot 서비스) | 불필요 (인프라 내부만으로 가능) |
| 연결 상태 확인 | 불가 | 가능 (API로 조회) |
| 장애 발생 가능성 | 높음 (health.html 변조에 취약) | 낮음 (timeout 시 자동 중지) |
| 추적성 | 작업자 추적 어려움 | 제어 요청과 결과를 로그로 추적 |
| 확장성 | 낮음 | 높음 |
Health check 방식은 health.html이 다른 작업으로 조금만 바뀌어도(삭제·이동·내용 변경) L4가 곧장 disable로 판단해 장애가 날 위험이 컸다. 그리고 결정적으로 연결 상태(current connection)를 확인할 방법이 없었다. 배포 전에 "정말 트래픽이 다 빠졌는지"를 못 보는 건 무중단 배포에서 치명적이다. 그래서 공수가 크더라도 L4 API 방식으로 갔다.
만든 것 — 멀티벤더 L4 제어 라이브러리
문제는 L4 장비가 한 종류가 아니라는 데 있었다. F5·A10 등 벤더마다 API 형태가 달랐다. 그래서 이걸 하나의 추상 인터페이스로 감싸는 Python 라이브러리를 만들었다.
- 제어 라이브러리 — 벤더별 REST API를 추상화해 관리자 로그인/로그아웃·세션 연장·노드 상태 조회/변경을 같은 인터페이스로 제공한다. 벤더별 API 설정은 설정 파일로 분리했다.
- 제어 실행기 — 상태를 바꾼 뒤 매 초 노드 상태와 current connection을 확인하고, 설정한 임계 시간 안에 조건을 만족하지 못하면 timeout 처리해 배포를 자동 중지한다.
- 셸 래퍼 —
enable/disable/forced-offline를 바로 실행할 수 있게 감쌌다.
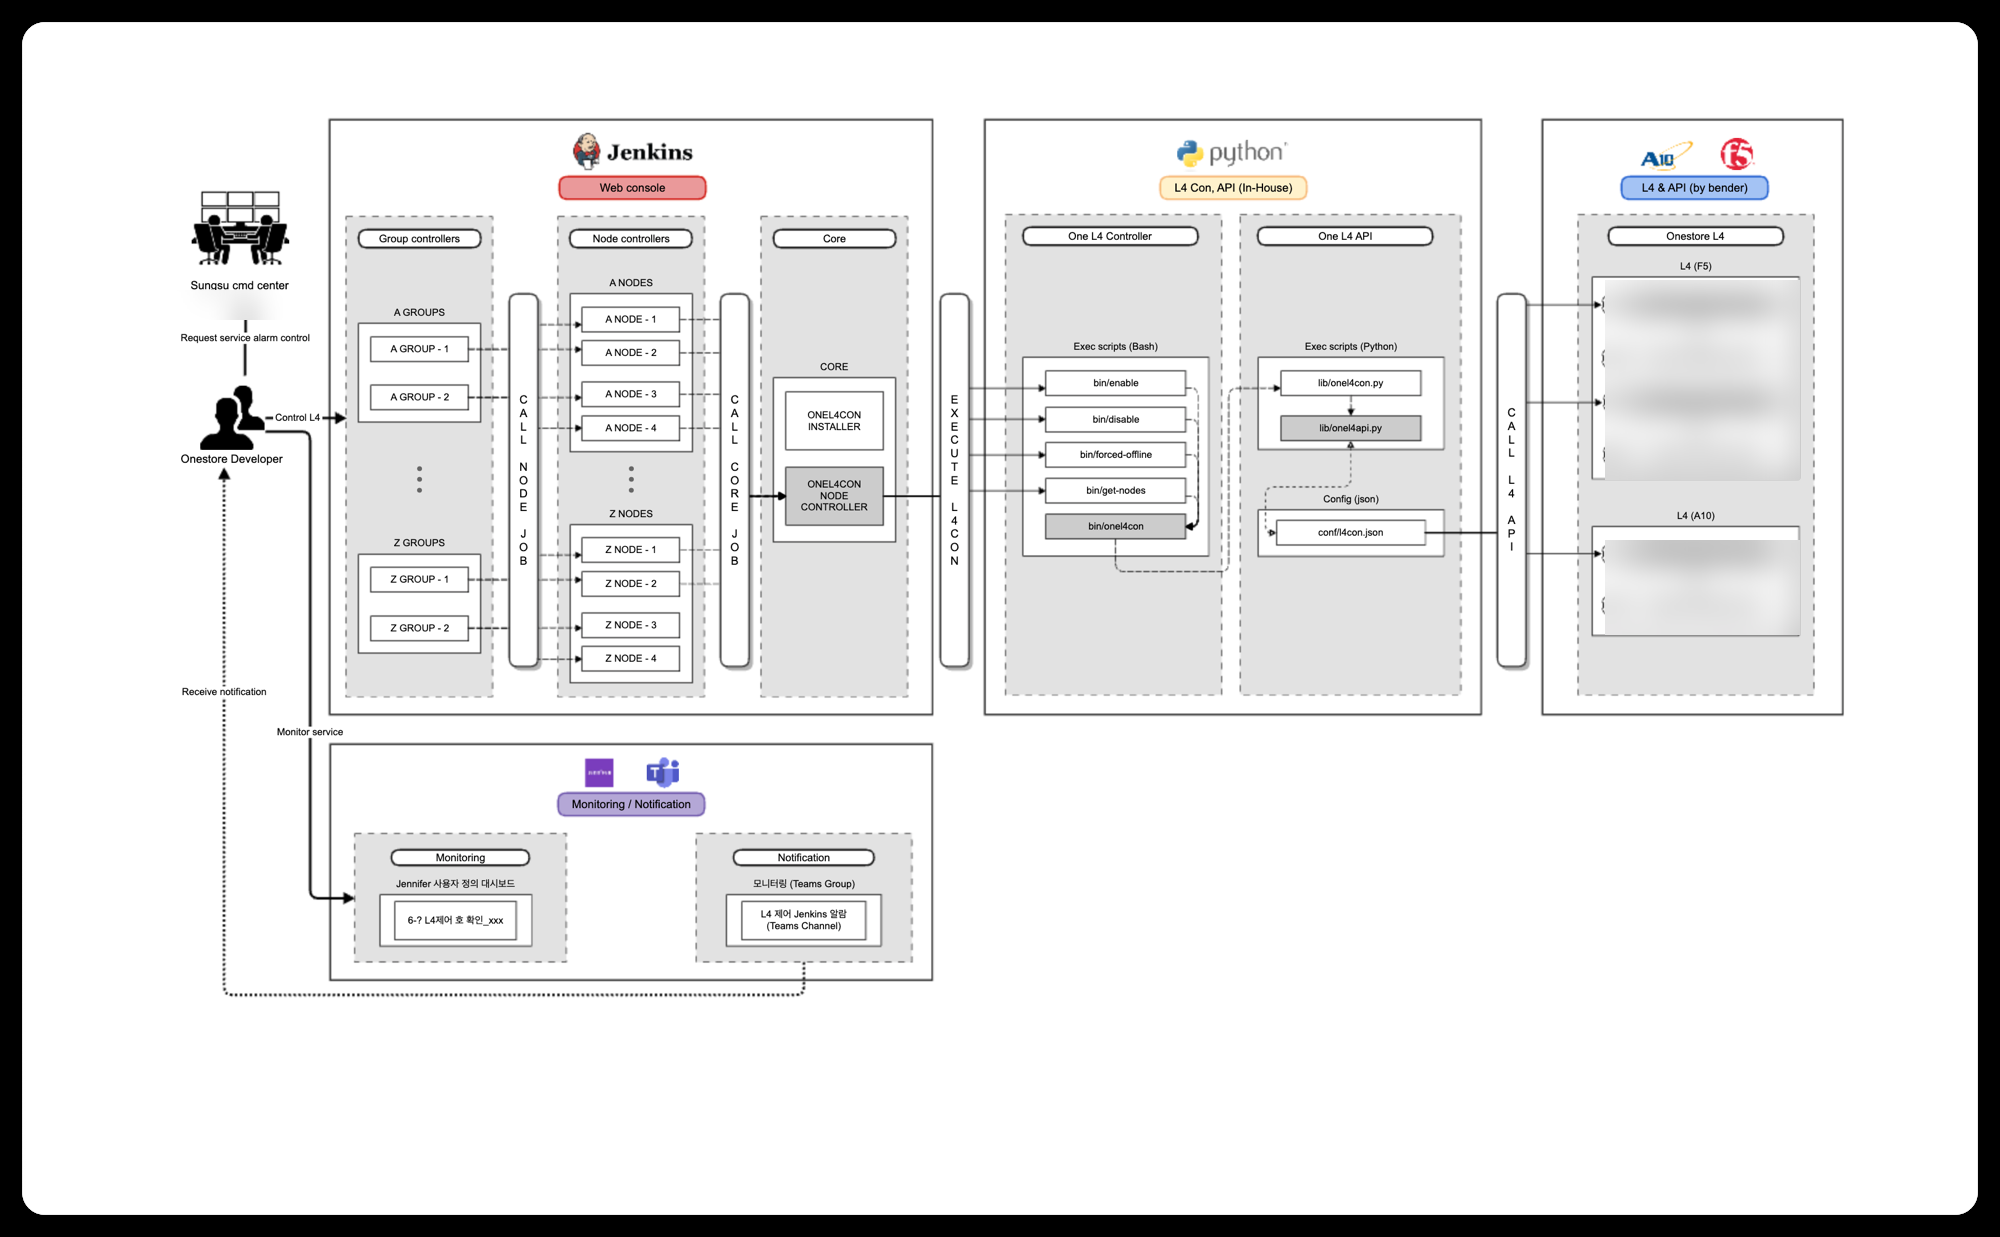
Jenkins(그룹/노드/코어 컨트롤러) → ONEL4CON → 멀티벤더 제어 라이브러리 → L4 장비(F5·A10) 구조.
이걸 Jenkins 파이프라인으로 묶어 배포 프로세스에 넣었다. 배포 준비 단계에서 대상 노드를 제어해 요청이 가지 않게 하고, 트래픽이 빠진 걸 확인한 뒤 배포하고, 끝나면 다시 올리는 흐름이다.
배포 준비 → 대상 노드 forced-offline → current connection 0 확인
        → (확인되면) 배포 진행 → 배포 후 enable
        → (확인 안 되면) timeout → 배포 자동 중지
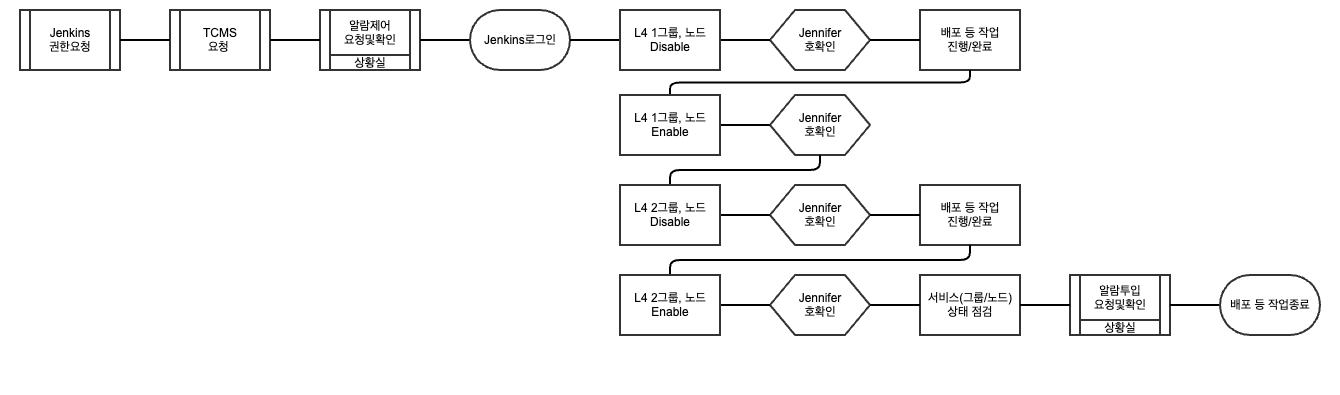
권한 신청 → 알람 제어 → 그룹/노드 Disable → 연결 상태 확인 → 배포 → Enable로 이어지는 배포 워크플로.
자동화의 핵심은 "안전장치"였다
코드로 옮기면서 가장 공들인 건 속도가 아니라 사람이 실수해도 안전하게 만드는 것이었다.
- disable → forced-offline로 변경. 기존 disable에서는 연결이 남아 있는 시간이 길어질 수 있어 forced-offline로 상태를 전환했다. 전환 후 2분간 대기하면서 current connection이 0인지 확인하고, 조건을 충족하지 않으면 배포를 중단했다.
- 그룹 간 중복 제어 방지(Lock 선점). 여러 그룹이 같은 노드를 동시에 건드리면 사고가 난다. 작업 전에 그룹을 Lock으로 선점하고, 누가 작업 중인지 화면에 표시되게 했다. 작업이 끝나면 Unlock한다.
- 권한 분리. 담당자는 자신이 담당하는 서비스만 제어할 수 있게 Jenkins 권한을 나눴다.
- 현황 가시화. 제어 상태(Enabled / Disabling / Disabled)와 현재 작업자(Lock 설정자)를 한눈에 보고, 연결 상태도 조회할 수 있게 했다. 모니터링은 APM 대시보드로, 제어 알림은 Teams 채널로 보냈다.
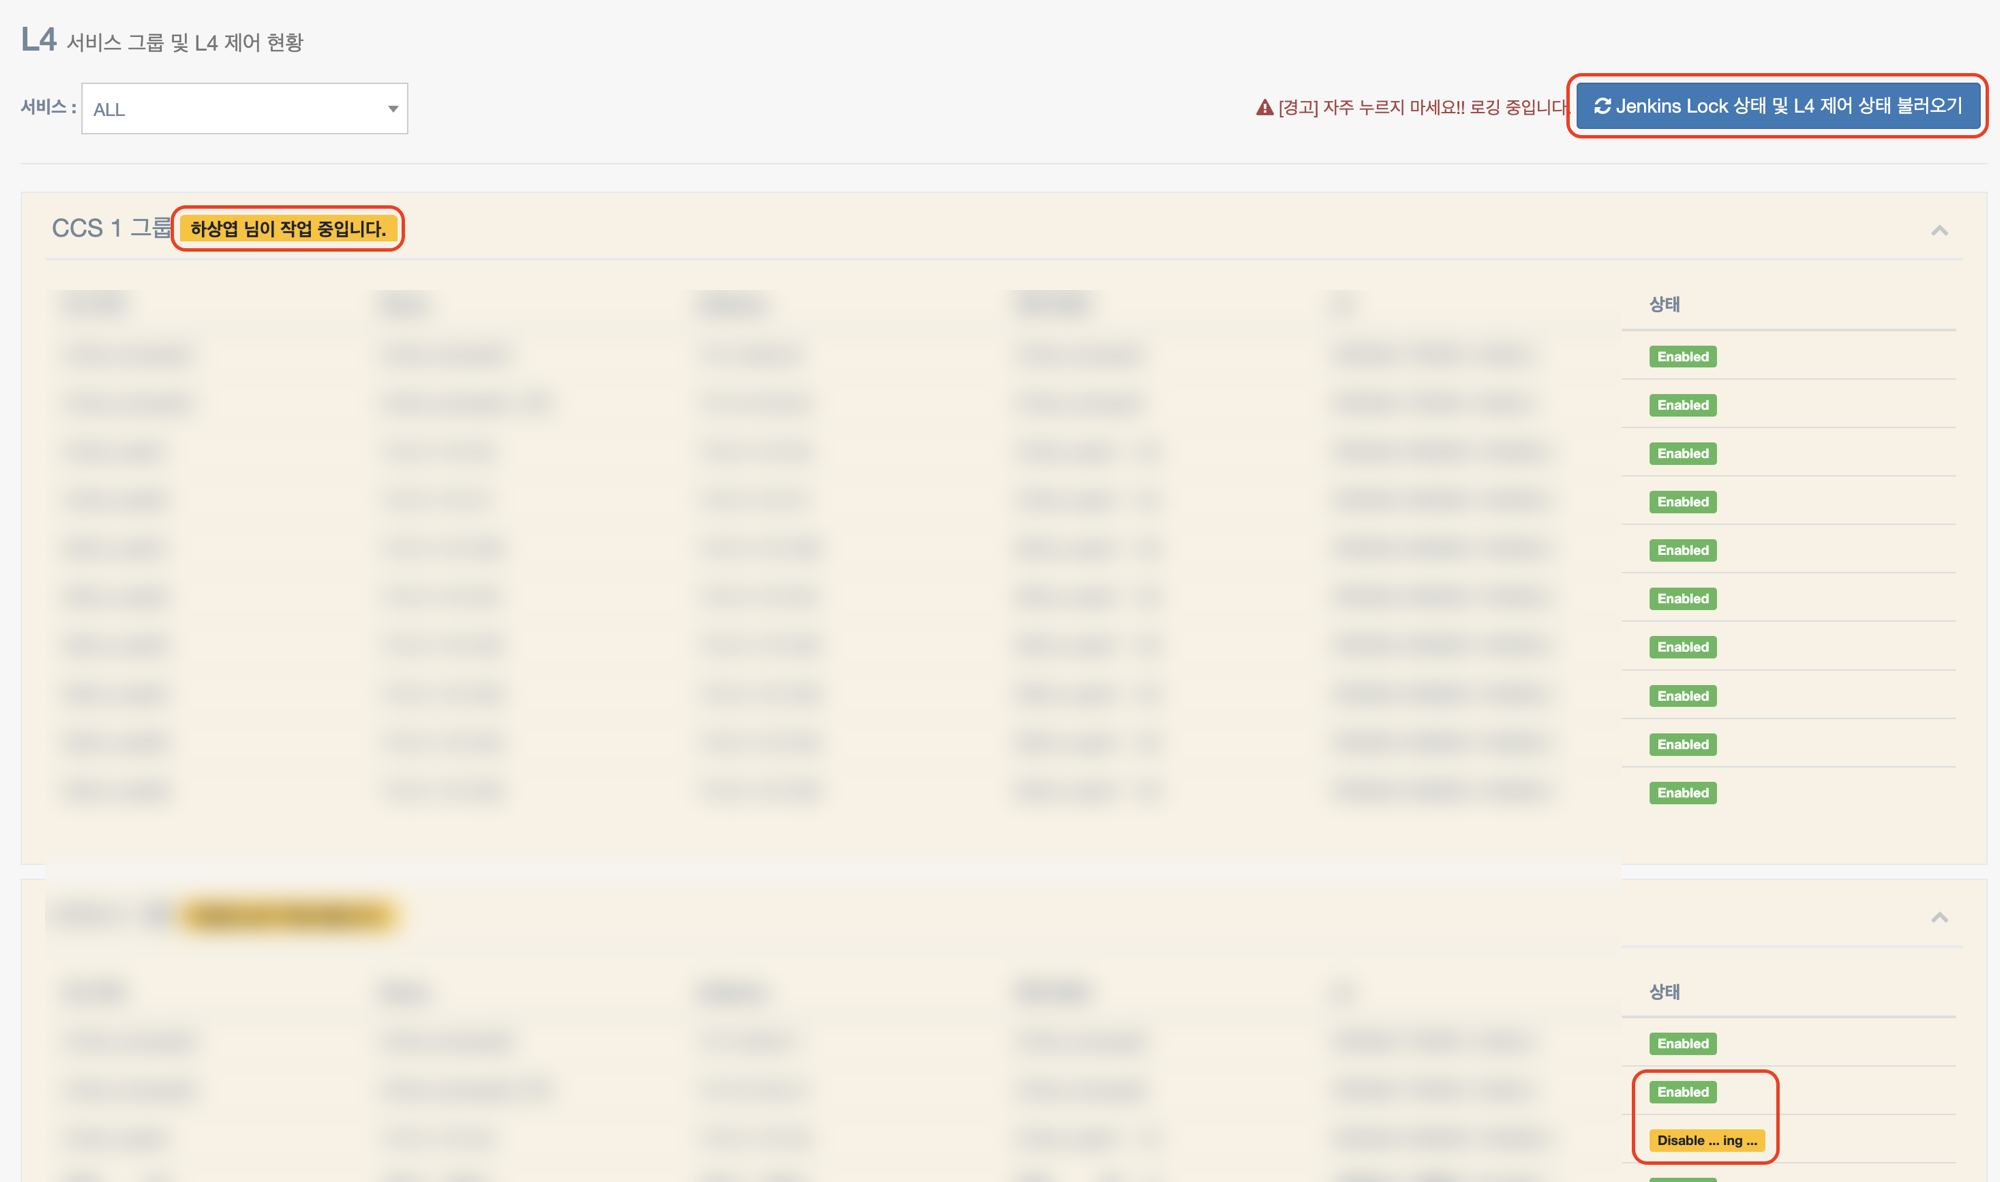
그룹별 제어 상태와 작업자(Lock)를 보여 주는 콘솔 화면.
결과
- 정해진 권한과 검증 절차 안에서 개발팀이 직접 절체 작업을 실행할 수 있게 됐다.
- 수동 콘솔 조작에서 오던 휴먼 에러와 커뮤니케이션 장애를 예방했다.
- 제어 요청과 결과를 로그로 남겨 작업자와 변경 내용을 추적할 수 있게 됐다.
- 그리고 이게 이후 CI/CD 무중단 배포의 핵심 빌딩블록이 됐다.
돌아보며
자동화라고 하면 "사람을 빼는 것"으로 생각하기 쉽지만 이 작업에서 배운 건 반대였다. 진짜 가치는 사람이 실수해도 시스템이 막아 주는 데 있었다. forced-offline 후 2분 대기, current connection이 0이 될 때까지 기다렸다가 안 되면 배포를 멈추기, 그룹 Lock으로 동시 제어 막기. 화려하지 않은 이 안전장치들이 실제로 장애를 줄였다. 단순히 콘솔 클릭을 코드로 바꾼 게 아니라 실수의 여지를 설계에서 없앤 것이 핵심이었다.
참고