전사에서 LLM 사용량이 늘어나면서 사용자·모델별 사용량, 비용 배분, 자격증명 관리 기준이 필요해졌다. 이 기능을 한곳에서 제공하기 위해 사내 LLM 게이트웨이를 구축했다. 이 글에서는 상용 제품 대신 직접 구현한 배경과 운영 구조를 정리한다.
시작은 Gemini, 그리고 막힌 지점들
사내 AI 서비스의 초기 개발에는 Gemini API를 사용했다. 기능 검증에는 문제가 없었지만 GCP가 주 계약 벤더가 아니어서 상용 운영에 필요한 예산과 계약 조건을 맞추기 어려웠다. 이후 Azure AI Foundry로 전환했으나, Foundry 자체에는 모델 호출 앞단에서 인증·쿼터·감사를 처리하는 게이트웨이 계층이 없었다.
APIM도 검토했지만 VNet·HA·self-hosted gateway를 전제로 한 Premium v2 구성은 모델 사용료와 별도로 상당한 고정비가 발생했다. 필요한 인증·쿼터·감사 기능과 예상 트래픽을 비교한 결과, 통제 계층을 자체 구현하는 편이 비용 면에서 적합하다고 판단했다. 팀 승인과 보안 검토를 거쳐 구축을 진행했다.
여기에 비용과 키 관리 문제도 겹쳐 있었다. 팀별 사용량을 비용 단위로 분리해 보기 어려웠고, 키의 소유자와 만료가 한 경로에서 보이지 않았다. 게이트웨이를 세울 거면 이런 운영 정보도 같이 정리하는 편이 낫다고 봤다.
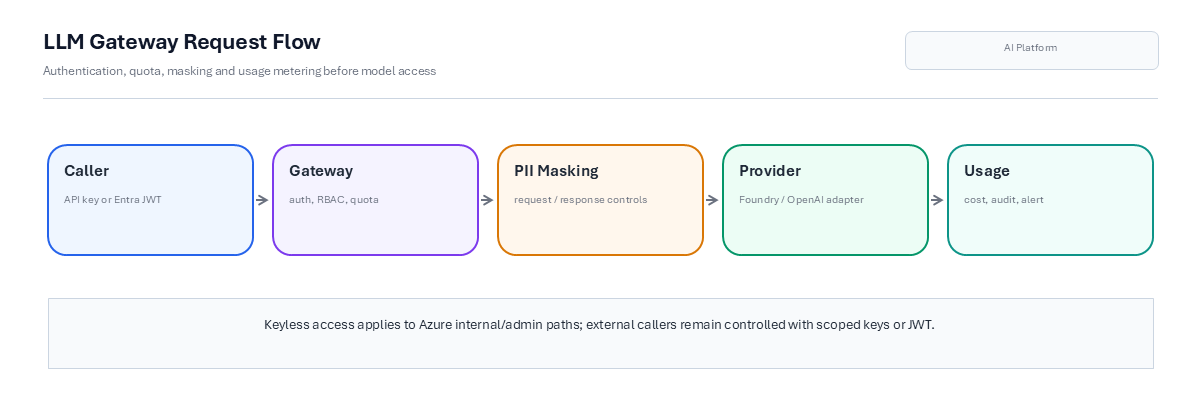
호출자는 게이트웨이에서 인증·쿼터·마스킹·사용량 측정을 거친 뒤 모델 프로바이더로 전달된다.
LiteLLM 대신 직접 구현한 이유
처음에는 LiteLLM과 같은 OSS 프록시에 인증과 쿼터 정책을 추가하는 방안을 검토했다. 그러나 요청·응답의 PII 마스킹, 감사 로그 보존, 사내 IdP 연동까지 포함하면 확장 범위가 커졌다. 장애 대응과 변경 책임의 범위를 명확히 하기 위해 직접 제어할 수 있는 게이트웨이를 구현하기로 했다.
Java 17과 Spring Cloud Gateway(reactive)를 기반으로 게이트웨이를 구현했다. 상태 데이터는 R2DBC로 비동기 처리하고 30여 개의 스키마 변경 이력은 Flyway로 관리한다. 추론 백엔드는 Foundry 관리형 서비스를 사용하고 인증·통제 계층만 자체 운영한다. 모델 목록은 Foundry에서 자동으로 discovery·sync하므로 새 모델이 추가돼도 게이트웨이 설정을 직접 수정할 필요가 없다.
요구사항 정리, 코드 초안 작성, 리팩터링과 테스트에는 Claude Code를 활용했다. Keyless·RBAC·FinOps 구조와 보안 경계는 직접 결정하고, 기능 단위로 생성된 변경을 검토해 반영했다.
사용 유형에 따른 6단계 권한 분리
처음에는 "사용자 / 관리자" 정도의 구분으로 시작했다. 그런데 임베딩만 쓰는 팀이 있는가 하면 고성능 모델이 필요한 팀, 도구 호출까지 하는 팀이 섞이면서 두 단계로는 권한과 쿼터를 충분히 표현하기 어려웠다. 그래서 역할을 더 세분화했다.
| 역할 | 권한 |
|---|---|
| ReadOnly | 사용량·카탈로그 조회 |
| Embedding | 임베딩 모델만 |
| Basic | 기본 모델 (낮은 쿼터) |
| Standard | 일반 모델 + 높은 쿼터 |
| Premium | 고성능 모델 + 도구 호출 |
| Admin | 정책·쿼터·전체 관리 |
역할마다 RPS와 일일 쿼터를 따로 걸었다. IdP 그룹을 역할에 매핑하고, 토큰 발급은 IdP가, 검증은 게이트웨이가 한다.
키를 줄이고 경계를 나눴다
장기 키가 돌아다니는 경로를 최대한 줄이는 데 신경을 썼다. Azure 내부 연동이나 운영자 Graph/Admin 경로는 Managed Identity + OBO(On-Behalf-Of) + Federated Identity Credential로 처리하고, 백엔드 local-auth도 꺼서 Azure 쪽 장기 키를 없앴다.
다만 모든 호출에서 API key가 사라진 건 아니다. 외부 서비스나 레거시 호출자는 scoped API key 또는 Entra JWT로 식별한다. 대신 키마다 소유자·쿼터·만료·감사 로그를 붙여 "익명으로 오래 살아남는 키"가 없게 만들었다. 정리하면 keyless는 Azure 내부와 운영자 경로의 이야기이고, 외부 호출자는 제한된 키나 JWT로 통제하는 구조다.
비용은 분 단위로 집계해서 막는다
비용 통제가 이걸 만든 가장 큰 이유였는데 청구서를 기다리면 이미 늦는다. 그래서 게이트웨이를 지나는 요청·응답 토큰을 분 단위로 집계하고 모델별 단가를 곱해 KRW로 환산한다. 사용자별 일/월 한도, 팀별 예산, 모델별 캡을 이 집계값에 걸어 두고 한도를 넘기면 즉시 차단한다. 알림은 룰 엔진으로 빼서 "이 팀 이번 달 예산 80%" 같은 경고를 미리 띄운다.
스트리밍 응답은 토큰 수를 끝까지 받아야 알 수 있어서, 응답이 끝나는 시점에 사용량을 확정하는 식으로 처리했다. 여기서 한 번 카운팅이 어긋나 집계가 살짝 틀어진 적이 있는데, 스트리밍이 중단된 경우를 빠뜨렸던 탓이었다.
감사 로그와 운영 콘솔
요청과 응답을 전부 PII 마스킹해 immutable 스토리지에 쌓는다. 30일은 hot, 1년은 cool, 그 뒤로는 archive로 둔다. 감사 요청이 들어오면 "이걸 언제부터 누가 쓰던 것이냐"를 시계열로 바로 추출할 수 있다.
운영 콘솔은 Next.js와 Mantine으로 구현했다. MSAL 기반 SSO를 적용하고, 쿼터 변경과 같은 작업은 승인 워크플로를 거치도록 했다. 운영 정보를 DB 조회에만 의존하면 담당자 외 사용자가 상태를 확인하거나 정책을 변경하기 어려우므로 별도 콘솔을 제공했다. 배포는 Jenkins pipeline-as-code로, bootJar 빌드 → 멱등한 SSH 배포 → 다단계 health check 순으로 실행한다.
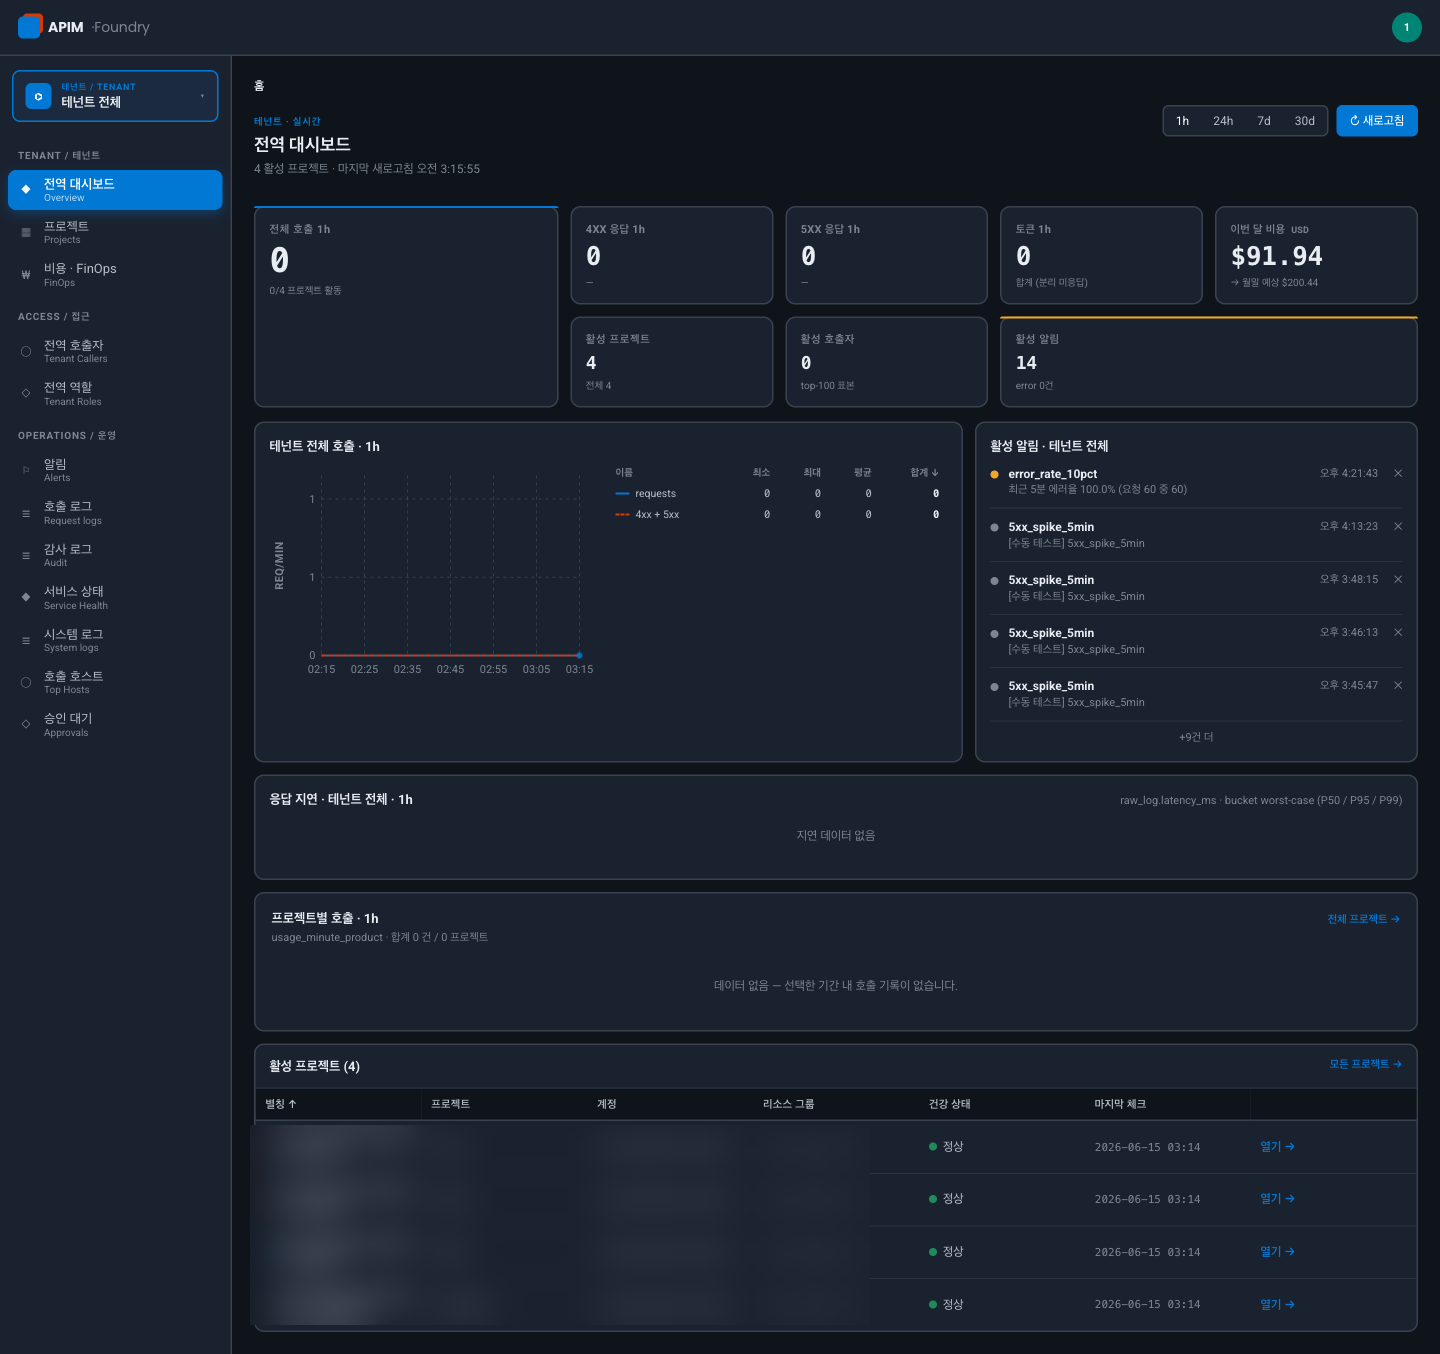
전역 대시보드 — 호출/오류율·토큰·이번 달 비용·활성 알림을 한 화면에서 본다.
돌아보며
직접 만든 게 항상 옳은 선택은 아니다. 운영 부담을 떠안는 일이기 때문이다. 다만 이번 건은 "통제 계층의 고정비"와 "직접 운영 부담"을 저울에 올렸을 때 우리 규모에서는 직접 만드는 쪽이 명확히 쌌다. 게이트웨이 계층 비용은 APIM Premium v2 구성보다 훨씬 낮게 잡혔고(자체 호스팅 기준, 토큰 비용 별도), 전사 LLM 트래픽을 한곳에서 인증·권한·쿼터·비용·감사로 통제하게 됐다.
게이트웨이 구축으로 모델 호출의 통제 기준은 마련했지만, LLM이 사내 시스템을 어떤 권한과 도구로 조회할지는 별도로 설계해야 했다. 이 문제는 이후 MCP 기반 사내 시스템 연동으로 이어졌다.
참고