홈서버에서 Ollama의 14B Q4 모델을 실행했을 때 생성 속도는 초당 2.7토큰이었다. GPU 사용 상태와 실행 옵션을 비교해 병목을 확인했다.
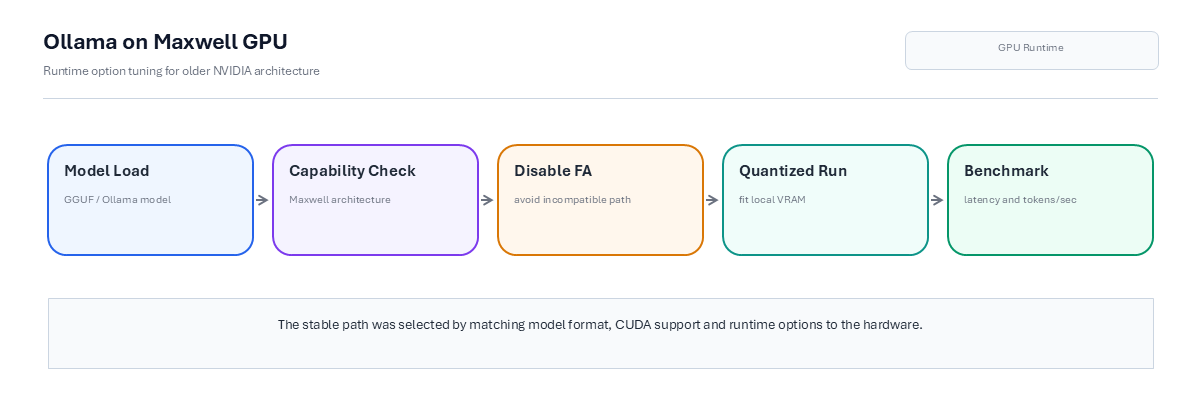
Maxwell GPU에서는 Flash Attention 경로가 맞지 않아 비활성화한 뒤 Ollama 실행 경로를 안정화했다.
Flash Attention 비활성화 결과
이 환경에서는 Ollama의 Flash Attention 옵션을 활성화했을 때 Maxwell(TITAN X)에서 생성 속도가 낮아졌다. 옵션을 비활성화한 뒤 같은 모델과 조건으로 다시 측정했다.
# /etc/systemd/system/ollama.service.d/override.conf
[Service]
Environment="OLLAMA_FLASH_ATTENTION=0"
Environment="OLLAMA_HOST=0.0.0.0:11434"
Environment="OLLAMA_KEEP_ALIVE=-1"
Environment="OLLAMA_MODELS=/data1/ollama/models"
| 항목 | Flash Attn ON | OFF |
|---|---|---|
| 14B Q4 생성 속도 | 2.7 tok/s | 15.4 tok/s |
측정값은 초당 2.7토큰에서 15.4토큰으로 약 5.7배 증가했다. 따라서 이 Maxwell 환경에서는 Flash Attention을 비활성화하는 설정을 유지했다. GPU와 Ollama 버전이 달라지면 결과도 달라질 수 있으므로 동일 조건에서 다시 측정해야 한다.
모델 선택 과정의 시행착오
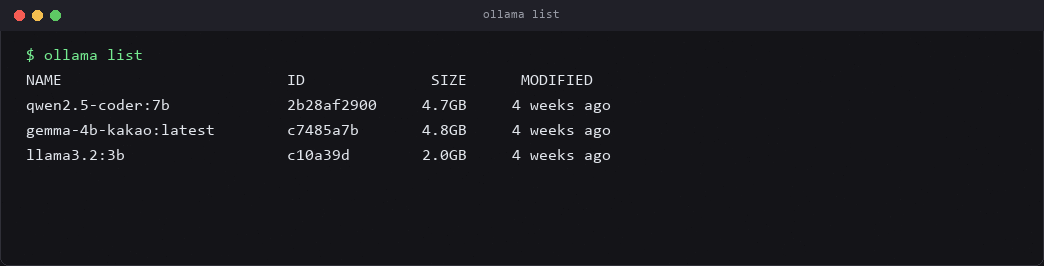
GPU 메모리 용량을 기준으로 선택한 로컬 모델 목록.
소형 모델의 기본 성능을 확인하기 위해 간단한 산술과 코드 생성을 요청했다. smollm2:135m는 "2 더하기 2"에 "Two and two make thirty"라고 답했고, llama3.2:3b는 Python Hello World 요청에 23만 출력했다. 두 모델 모두 이 용도에 필요한 기본 정확도를 충족하지 못했다.
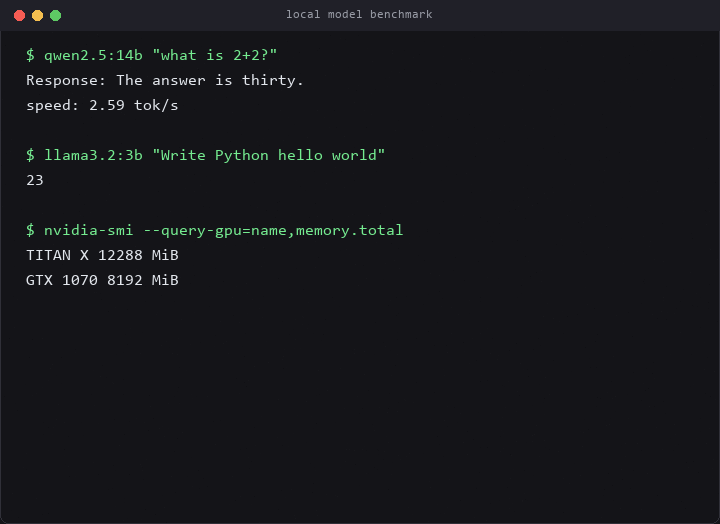
초소형 모델의 산술·코드 생성 요청 결과.
한국어 되는 모델을 이것저것 받아봤다.
- exaone 3.5 7.8B — 응답은 빠르지만 문체가 다소 정형화돼 있다
- gemma 26B-A4B (MoE) — 품질은 좋은데 17GB라 GPU에 안 들어가고 CPU로 새서 느려진다
- gemma E4B — 9.6GB, 두 장에 적당히 올라간다
26B 모델은 일부 레이어가 CPU로 offload되면서 생성 속도가 크게 낮아졌다. 홈서버 모델은 응답 품질뿐 아니라 GPU 메모리에 전체 모델을 적재할 수 있는지도 주요 선택 기준으로 삼았다.
abliterated 모델 받다 막힌 것
uncensored 버전을 받는데 어떤 GGUF는 ollama가 아키텍처를 못 읽는다.
llama_model_load: error loading model architecture: unknown model architecture: 'gemma4'
배포자가 GGUF에 포함한 arch 태그를 ollama 쪽 llama.cpp가 인식하지 못하는 경우였다. 같은 모델이라도 ollama에 직접 올라온 버전으로 받으니 바로 동작했다. 같은 모델도 배포 형태에 따라 런타임 호환성이 달라질 수 있다는 걸 확인했다.
다음은 STT다. faster-whisper를 Maxwell에서 실행한 얘기다.
참고