피카츄 배구를 Python 환경으로 옮기고 PPO 강화학습 에이전트를 적용했다. 에이전트는 레벨 1~5의 규칙 기반 봇을 상대로 학습하며, 진행 상태를 확인할 수 있도록 웹 대시보드도 구성했다. 아래 이미지는 저장소의 애플리케이션을 실행한 뒤 /visual?scene=powerhit에서 직접 캡처한 화면이다.
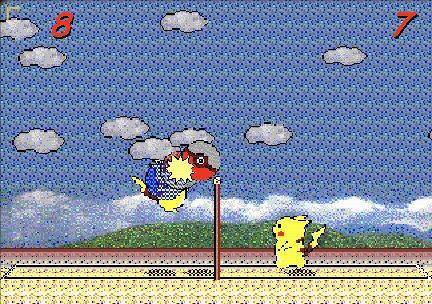
프론트엔드가 실제 게임 상태를 그린 power-hit 프레임. 트레일, 임팩트 링, 점수판까지 그대로 나온다.
학습 환경 구성
관찰은 18차원으로 정규화했다(공 위치/속도, 두 플레이어 위치 같은 것). 행동은 12개 이산 행동이다. 환경을 8개 띄워서 병렬로 돌렸고 25fps 게임 루프를 그대로 옮겼다. 알고리즘은 Stable-Baselines3의 PPO로 시작했다.
env = SubprocVecEnv([make_env(i) for i in range(8)])
model = PPO("MlpPolicy", env,
            n_steps=2048, batch_size=256,
            gamma=0.99, gae_lambda=0.95)
model.learn(total_timesteps=500_000)
500K 돌렸는데 승률이 28%에서 멈췄다
문제는 이 지점에서 드러났다. 50만 스텝을 돌렸는데 레벨 1 봇 상대로 승률이 28%에서 더 오르지 않았다. 보상 곡선은 우상향인데 정작 게임은 계속 졌다. 보상은 오르는데 승률이 오르지 않는다는 점이 가장 이상한 신호였다.
로그를 확인해 보니 원인이 보였다. 학습 초반에 행동을 유도하려고 shaping 보상을 많이 넣어두었다. 공에 다가가면 +0.05/프레임, 받을 준비를 하면 +0.01/프레임을 주는 식이었다. 그런데 한 게임이 3000프레임 정도 이어지면 이 작은 보상만으로도 에피소드당 +100을 넘겼다. 게임 승리 보상은 +20이었다. 에이전트 입장에서는 승리보다 코트 안에서 shaping 보상을 계속 받는 편이 더 유리했다.
초기 보상 설계가 승리와 다른 행동을 강화하고 있었다. 이 실험에서는 보상 설계 자체가 학습 실패의 원인이었다.
보상부터 다시 조정했다
승패 보상의 비중을 높이고 행동을 유도하는 shaping 보상은 줄이는 방향으로 조정했다.
| 신호 | 이전 | 바꾼 뒤 |
|---|---|---|
| 게임 승리 | +20 | +50 |
| 게임 패배 | -20 | -50 |
| 공한테 접근 (프레임당) | +0.05 | +0.02 |
| 준비 자세 (프레임당) | +0.01 | +0.005 |
| 랠리 타임아웃 | -5 | -12 |
| 공격 압박 (신규) | — | +0.02 |
승패 보상을 2.5배로 키워 shaping 보상이 승패 보상을 압도하지 못하게 만들고, shaping 보상은 절반 수준으로 줄였다. 공만 반복해서 건드리는 행동을 줄이기 위해 "네트 넘어 상대 쪽으로 공을 보내는" 공격 신호도 새로 넣었다. 끝나지 않고 길어지는 랠리 패널티도 실점보다 크게 설정했다.
다시 실행하니 100K 스텝 시점에 승률이 22.6%까지 단조 증가했다. 이전 보상으로는 같은 구간에서 16.7%였다. 곡선 모양 자체가 안정적으로 바뀌었다. shaping 보상으로 빠지던 학습이 줄어들자 승리 쪽으로 방향을 잡기 시작했다.
같은 /visual 화면에서 잡은 game-end 장면. 학습 루프는 이 게임 상태를 관찰값과 보상으로 바꿔 PPO에 넘긴다.
운영 중 확인한 것들
학습을 대시보드에서 stop 버튼으로 멈출 수 있게 했는데 수천 스텝 실행 중인 작업이 실수로 중단된 적이 있었다. 그 뒤로 10K 스텝을 넘으면 force 없이는 멈추지 못하게 막고, SIGTERM이 들어오면 마지막 체크포인트를 저장한 뒤 종료되게 했다. 서버가 갑자기 재부팅돼도 그 지점에서 이어서 실행할 수 있게 하기 위해서였다.
평가 쪽에서도 문제가 있었다. 스모크 테스트를 환경 1개(n_envs=1)로만 돌리고 있었는데 실제 학습은 8개 환경으로 실행하면서 텐서 shape이 맞지 않는 문제가 발생했다. QA 단계에서 확인했고, 이후 스모크 테스트도 실제와 비슷한 설정(n_envs>=2)으로 돌리는 규칙을 추가했다.
코딩 에이전트 활용 범위
이 프로젝트에는 앞 글에서 정리한 멀티 에이전트 구성을 적용했다. RL, 프론트엔드, 디자인, DevOps, QA 역할별 에이전트는 코드 초안과 테스트 항목을 제안했다. 요구사항 분리, 보상 함수 설계, PR 검토와 병합, 학습 결과 검증은 직접 수행했다. 대시보드 중단 방지, 체크포인트 저장, n_envs 스모크 테스트와 같은 운영 안전장치도 직접 검증했다.
PR 히스토리에는 역할별 작업 범위를 구분하기 위해 feat(rl), feat(design), feat(devops) 등의 태그를 남겼다. 요구사항·보상 함수·통합 기준은 직접 정하고 코딩 에이전트는 코드 초안과 테스트 제안을 병렬로 만드는 데 활용했다.
이 작업에서는 강화학습 보상 설계와 멀티 에이전트 개발 방식을 함께 적용했다. 보상 신호가 목표와 어긋나면 에이전트가 의도하지 않은 행동을 일관되게 학습한다는 점도 확인했다.
참고