제목과 달리 이 작업의 결론은 "autovacuum을 더 강하게 설정하자"가 아니었다. PostgreSQL RDS에서 Vacuum의 실행 조건과 IOPS·Queue Depth 변화를 확인하고, 대형 테이블의 운영 기준을 정리하는 데 초점을 맞췄다.
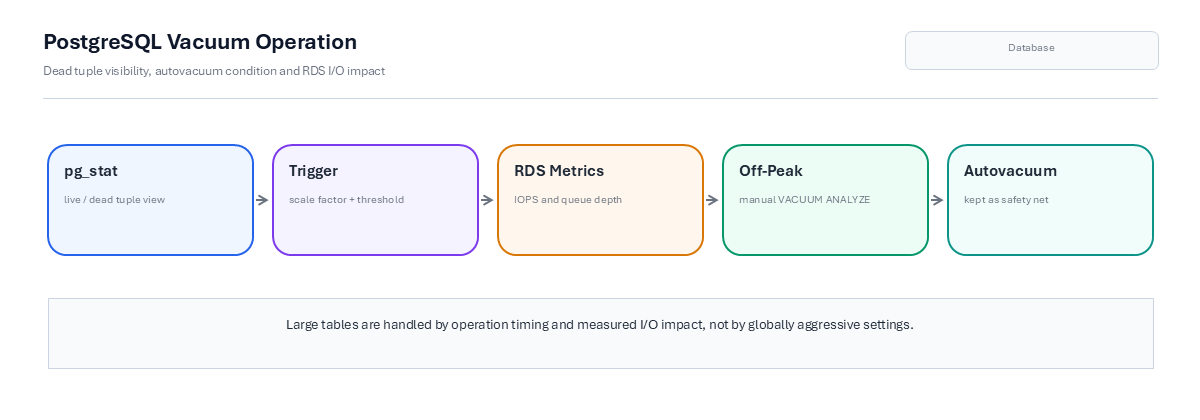
dead tuple이 쌓이는 조건과 RDS I/O 영향을 먼저 보고, 대형 테이블은 저사용 시간대 VACUUM ANALYZE 대상으로 분리했다.
먼저 dead tuple부터 봤다
PostgreSQL에서 UPDATE나 DELETE가 일어나면 기존 row를 그 자리에서 바로 덮어쓰거나 지우는 식으로 끝나지 않는다. MVCC 때문에 기존 버전은 남고, 새 버전이 생기거나 더 이상 참조되지 않는 tuple이 남는다. 이게 dead tuple이다. dead tuple이 계속 쌓이면 테이블과 인덱스를 읽을 때 불필요한 I/O가 늘고, Free Space Map으로 재사용할 공간을 관리해야 한다.
먼저 pg_stat_user_tables에서 테이블별 통계를 확인했다.
SELECT relname, n_live_tup, n_dead_tup,
       last_vacuum, last_autovacuum,
       last_analyze, last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_live_tup DESC;
여기서 live tuple과 dead tuple 규모, 마지막 vacuum/analyze 시각을 같이 봤다. 작은 테이블 하나에서 autovacuum이 돈 뒤 n_dead_tup이 50에서 0으로 내려가고 last_autovacuum이 갱신되는 것도 확인했다. 기능 자체는 정상인데 문제는 큰 테이블이었다.
autovacuum은 너무 늦게 시작될 수 있다
autovacuum은 대략 아래 조건을 만족하면 돈다.
n_dead_tup >= n_live_tup * autovacuum_vacuum_scale_factor
              + autovacuum_vacuum_threshold
기본값 기준으로 autovacuum_vacuum_scale_factor는 0.2, autovacuum_vacuum_threshold는 50이다. 1,000행 규모의 테이블에서는 발동 기준이 낮지만, live tuple이 10억 개인 테이블은 추정 dead tuple이 약 2억 건에 도달해야 조건을 충족한다. 그 사이 쿼리는 계속 큰 테이블을 읽고, autovacuum이 시작될 때 처리해야 할 페이지 수도 많아질 수 있다.
RDS에서는 I/O가 먼저 튀었다
당시 RDS 지표에서 Vacuum 작업 중 IOPS와 Queue Depth가 튀는 걸 확인했다. CPU나 메모리보다 디스크 쪽 영향이 먼저 보였다. Vacuum이 live tuple과 dead tuple이 섞인 페이지를 훑고, dead tuple을 정리하고, 재사용 가능한 공간을 표시하는 작업이다 보니 큰 테이블에서는 I/O 부하가 눈에 띄게 올라갔다.
live tuple과 dead tuple 합계가 1,000만 개 이상인 테이블들만 수동 Vacuum을 돌려봤을 때는 전체 작업에 약 25분 정도가 걸렸다. 작업 후에도 dead tuple이 완전히 0으로 떨어지지는 않았다. Vacuum 중에도 서비스의 CRUD는 계속 일어나고, cost limit에 걸리면 한 번에 다 정리되지 않을 수 있기 때문이다.
그래서 수동 VACUUM을 없애지 않았다
이 포인트가 중요했다. 해결책은 "autovacuum을 끄고 수동으로만 하자"도 아니고, "scale factor를 확 낮춰서 더 자주 돌리자"도 아니었다.
대형 테이블은 사용량이 적은 시간대에 VACUUM (VERBOSE, ANALYZE)를 정기적으로 돌리는 쪽이 더 안전하다고 봤다. autovacuum은 그대로 둔다. 수동 작업이 실패하거나 UPDATE/DELETE가 몰려서 낮 시간대라도 정리가 필요하면 autovacuum이 마지막 안전장치로 돌아야 하기 때문이다. 그리고 수동 Vacuum을 할 때는 Analyze도 같이 돌려야 한다. 통계가 갱신되지 않으면 쿼리 플랜이 틀어져서 다른 성능 문제가 생길 수 있다.
반대로 autovacuum_vacuum_scale_factor를 0에 가깝게 두고 threshold 고정값으로만 제어하는 방식은 적용하지 않는 쪽으로 봤다. 발동 시점은 앞당길 수 있지만 너무 잦은 autovacuum이 다시 I/O 오버헤드가 될 수 있어서였다.
메모리 파라미터도 같이 봤다
당시 인스턴스 메모리는 32GB였고 maintenance_work_mem은 518MB 수준이었다. Vacuum, CREATE INDEX, ALTER TABLE 같은 유지보수 작업에 쓰는 메모리라서 1.6GB에서 2GB 정도까지 올리는 방안을 검토했다. 전체 메모리의 약 1/16 또는 5% 안팎을 기준으로 잡으면 그 정도가 자연스러웠다.
autovacuum_work_mem과 autovacuum_max_workers는 바로 건드리지 않는 쪽이었다. 작은 테이블이 아주 많은 구조라면 worker를 늘리는 쪽이 유리할 수 있지만, 이 케이스는 큰 테이블 몇 개가 문제였고 autovacuum worker마다 메모리가 잡히는 구조도 같이 봐야 했다. 무작정 병렬도를 올리면 해결보다 부하가 먼저 올 수 있다.
남은 기준
운영 기준은 다음과 같이 정리했다.
- dead tuple이 어디에 쌓이는지 먼저 본다.
- autovacuum 발동 조건을 테이블 크기와 같이 계산한다.
- Vacuum 중 RDS IOPS와 Queue Depth를 같이 본다.
- 대형 테이블은 저사용 시간대 수동
VACUUM ANALYZE대상으로 분리한다. - autovacuum은 끄지 않고 안전장치로 둔다.
- scale factor나 worker 수를 전체에 공격적으로 바꾸기 전에 I/O 비용부터 본다.
PostgreSQL Vacuum은 단순한 정리 작업으로만 볼 수 없다. 시작 시각, 작업 시간, 읽기·쓰기 부하와 같은 시간대의 서비스 트래픽을 함께 고려해야 한다.
참고