Teams에서 위키 문서나 Jira 이슈를 질문하면 관련 내용을 찾아 답하는 어시스턴트를 약 일주일에 걸쳐 만들었다. 처음부터 멀티 에이전트 구조를 택하지 않고 단일 챗봇에서 시작해 기능과 역할을 단계적으로 분리했다. 이 글은 6일 동안의 변경 과정을 정리한다.
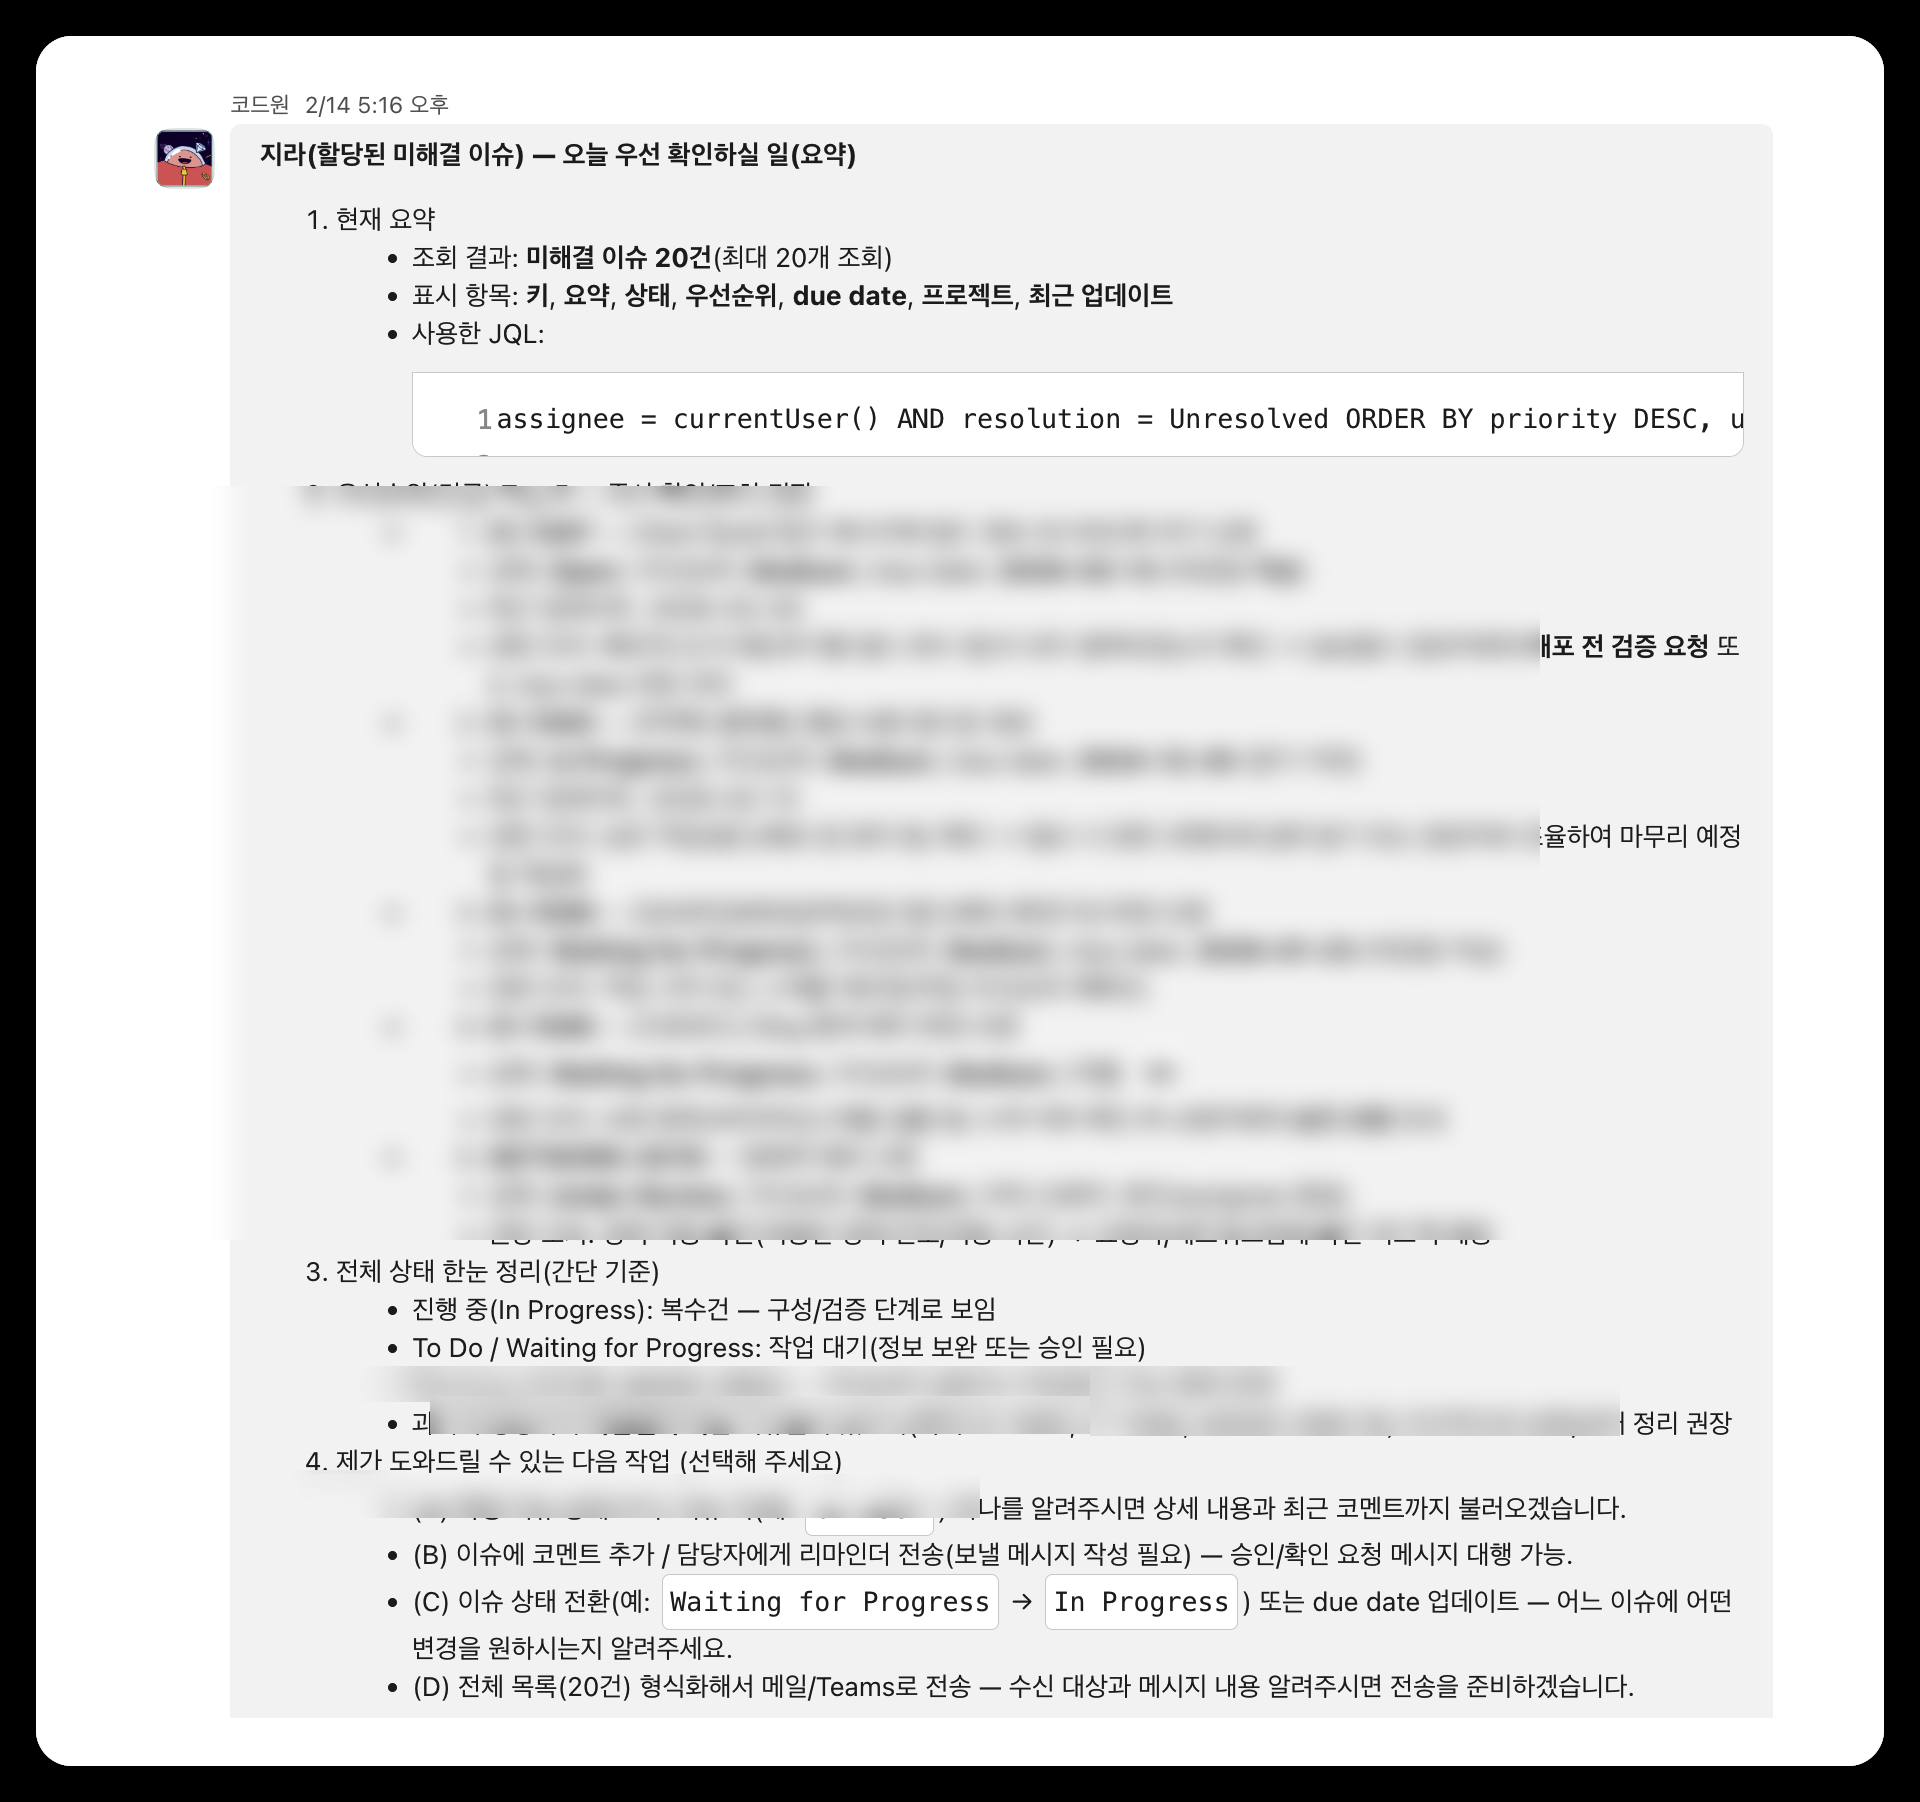
어시스턴트가 Teams에서 내 미해결 Jira 이슈를 우선순위로 정리해 준다.
1일차 — RAG 챗봇 구성
검증된 구성 요소를 조합해 기본 구조를 만들었다.
- MCP Atlassian 서버 — Docker 멀티아키텍처(amd64/arm64)로 빌드해 K8s에 배포
- n8n — 워크플로우 엔진
- Bot Framework — Teams Bot → n8n 웹훅 연결
- pgvector — PostgreSQL 17 + pgvector 확장
여기에 Confluence와 Jira를 공간별·프로젝트별로 파티션해 수집하는 파이프라인을 붙이고, System Prompt·Vector Store·Chat Memory를 묶어 RAG 챗봇을 만들었다. Teams에서 질문하면 사내 문서를 검색해 답하는 가장 단순한 형태다.
2일차 — 도구와 편의 기능
사내 문서 검색 외에 일반 질문과 웹 검색을 지원해 달라는 요청이 있어 Jina AI Search/Reader를 연동했다. 클러스터 상태를 조회할 수 있도록 Kubernetes MCP 서버도 연결했다. 질문 유형을 분류해 적절한 도구를 선택하도록 구성하고, 응답 시간과 토큰 수를 메타데이터로 제공했다. /도움말·/초기화·/상태 명령도 이 단계에서 추가했다.
3일차 — pgvector에서 Qdrant로
수집 문서가 늘어나면서 벡터 검색 저장소를 Qdrant로 변경했다. pgvector로도 검색할 수 있었지만, HNSW 최적화·payload 인덱스·양자화를 활용하기에는 Qdrant가 더 적합하다고 판단했다.
벡터 DB는 내 주 전문 분야가 아니어서 같은 팀 DBA의 검토와 LLM의 도움을 받았다. 인덱스·양자화·이관 방식은 DBA와 논의해 결정했고, 이관 코드와 설정 작성에는 LLM을 활용했다.
Qdrant를 Helm으로 배포하고, 컬렉션을 1536차원·Cosine·HNSW·Scalar 양자화로 만든 뒤 6개 payload 인덱스를 걸었다. 그런 다음 기존 77,315건을 pgvector에서 Qdrant로 이관했다.
초기 OFFSET 기반 대량 조회는 ECONNRESET 오류로 중단됐다. UUID 기준 cursor 페이지네이션으로 변경한 뒤 처리 속도가 OFFSET 방식보다 10배 이상 빨라졌다. 이후 100건 단위로 upsert해 77,315건을 약 30분 만에 오류 없이 이관했다.
마지막 날 — 역할별 에이전트 분리
기존에는 하나의 에이전트가 모든 도구를 탐색하고 고성능 모델을 사용했다. 이 구조는 응답 시간이 길고 질문의 난이도와 관계없이 비용이 발생했다. 이를 개선하기 위해 분류기와 네 개의 역할별 에이전트로 구조를 변경했다.
질문 → Query Classifier (general / internal / external / operations)
        → Agent Router (Switch)
            ├─ General Agent  : 일반 질문
            ├─ RAG Agent      : 사내 문서(Qdrant 벡터 검색)
            ├─ Search Agent   : 웹 검색
            └─ Ops Agent      : MCP 도구 기반 인프라 운영
역할별로 다른 모델을 사용했다. 분류에는 경량 모델을, 일반 질문과 웹 검색에는 중간급 모델을 배치했다. 사내 문서 RAG와 인프라 운영처럼 정확도가 중요한 작업에만 상위 모델을 사용했다. 질문을 먼저 분류한 뒤 적합한 모델과 도구로 전달함으로써 응답 시간과 비용을 줄이고 역할별 답변 정확도를 높였다.
전환 과정에서 데이터 복구 경로와 서버 확장 구성도 보완했다.
- Dual-Write — 수집 시 pgvector와 Qdrant에 동시 저장하고, 15분 주기로 pgvector→Qdrant 동기화를 돌려 보정한다. Qdrant가 메인이지만 pgvector를 백업으로 두어 언제든 재동기화할 수 있게 했다.
- MCP 서버 스케일 아웃 — Atlassian MCP 레플리카를 1 → 3으로 늘렸다.
- 정리 — 테스트·구버전 워크플로 8개를 지워 12개 → 4개로, 비활성 노드를 정리해 51 → 47개로 줄였다.
구축 과정에서 해결한 문제
서로 다른 구성 요소를 연동하는 과정에서 다음 문제를 확인하고 수정했다.
- Qdrant CrashLoopBackOff — Helm values의 storage 섹션 중복 설정이 원인. 중복 제거로 해결.
Cannot find module 'pg'— n8n 컨테이너 안의 Node.js 모듈 경로를 정확히 지정해 해결.- 마이그레이션 ECONNRESET — 위에서 말한 OFFSET → cursor 전환.
- 분류기 모델 오류 — 가장 가벼운 모델이
temperature=0을 지원하지 않아 파라미터를 빼고 기본값을 쓰도록 수정. - 벡터 DB 크레덴셜 저장 — n8n이 크레덴셜을 다루는 방식과 맞지 않아 crypto-js로 AES 암호화해 저장.
돌아보며
약 일주일 안에 기본 기능을 구현할 수 있었던 이유는 검증된 구성 요소와 LLM 개발 도구를 활용했기 때문이다. n8n·MCP·Qdrant·Bot Framework를 연동했고, 워크플로 구성과 마이그레이션 스크립트 작성에 LLM을 활용했다. 구축 문서의 초안도 어시스턴트가 시스템 정보를 바탕으로 생성하도록 구성했다.
처음부터 멀티 에이전트 구조를 적용하지 않고 단일 에이전트로 기능을 검증한 덕분에 응답 시간과 비용의 병목을 구체적으로 확인할 수 있었다. 이후 분류기와 역할별 에이전트를 도입하면서 변경 목적과 효과도 명확하게 측정할 수 있었다. 이번 작업에서는 단순한 구조로 시작한 뒤 확인된 병목을 기준으로 역할을 분리하는 순서가 효과적이었다.
참고