홈서버 클러스터에 올릴 로컬 모델 후보를 추려보려고 작은 모델부터 받아서 실행해 봤다. smollm2 135M을 받아서 테스트 삼아 2+2를 물어봤는데 30이라고 했다.
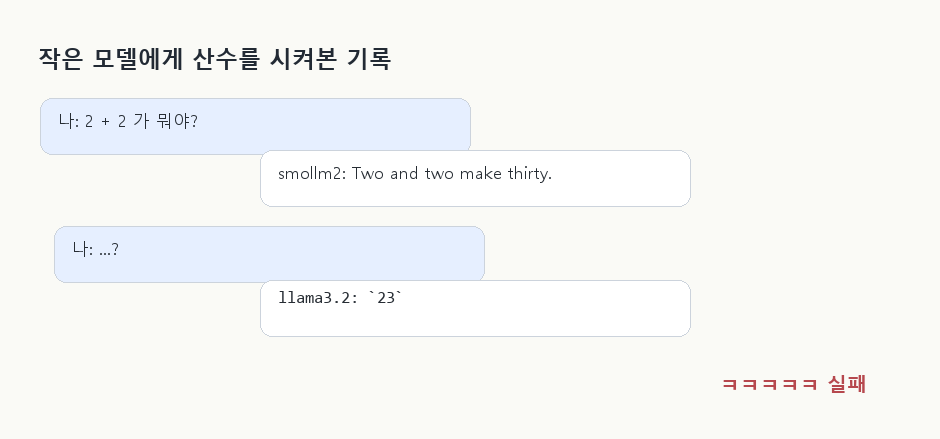
SmolLM2 135M이 2+2 질의에 30으로 응답한 실행 화면.
처음에는 프롬프트 입력을 잘못했는지 확인했다. 같은 질문을 반복해도 결과는 달라지지 않았다. 135M 규모의 모델에 간단한 산술 능력까지 기대하기 어렵다는 점을 확인한 사례였다.
상대적으로 큰 llama3.2 3B에는 "Python Hello World를 작성해 달라"고 요청했지만 결과는 23뿐이었다. 코드 형식도 아니었고 요청과의 연관성도 확인하기 어려웠다.
이번 확인에서는 1B 미만 모델이 간단한 산술 질의도 안정적으로 처리하지 못해 대화 모델 후보에서 제외했다. 다만 표준 벤치마크나 반복 평가를 수행한 것은 아니므로, 이 결과만으로 파라미터 수와 품질의 일반적인 관계를 판단할 수는 없다.
테스트 장비의 무선 어댑터가 5GHz 대역을 지원하지 않아 모델 다운로드에도 수 시간이 걸렸다. 기본 질의 응답과 장비 자원을 함께 고려해 최종 후보로 Gemma를 선택했다.
참고