셀프호스팅으로 운영하는 서비스가 열 개 가까이 늘면서 일부 서비스가 중단돼도 바로 인지하지 못하는 일이 생겼다. RSS 리더가 사흘 동안 중단된 뒤 직접 접속하면서 발견한 적도 있었다. 장애 감지와 알림을 자동화하기 위해 Uptime Kuma와 ntfy를 구성했다.
그래서 상태를 대신 지켜볼 도구로 Uptime Kuma를 올렸다.
컴포즈 하나면 끝
설치는 간단하다. 컨테이너 하나를 띄우면 된다.
# compose.yaml
services:
  uptime-kuma:
    image: louislam/uptime-kuma:1
    container_name: uptime-kuma
    volumes:
      - ./data:/app/data
    ports:
      - "3001:3001"
    restart: unless-stopped
데이터는 ./data에 SQLite로 쌓이니 백업은 그 디렉터리 하나만 챙기면 된다.
단 하나의 규칙: 다른 호스트에 둔다
설치보다 중요한 것은 배치 위치였다. 감시 도구를 감시 대상과 같은 호스트에 두면 호스트 장애 시 감시 도구도 함께 중단돼 알림을 보낼 수 없다. 이를 피하기 위해 여유 자원이 있는 다른 장비에 Uptime Kuma를 배치했다.
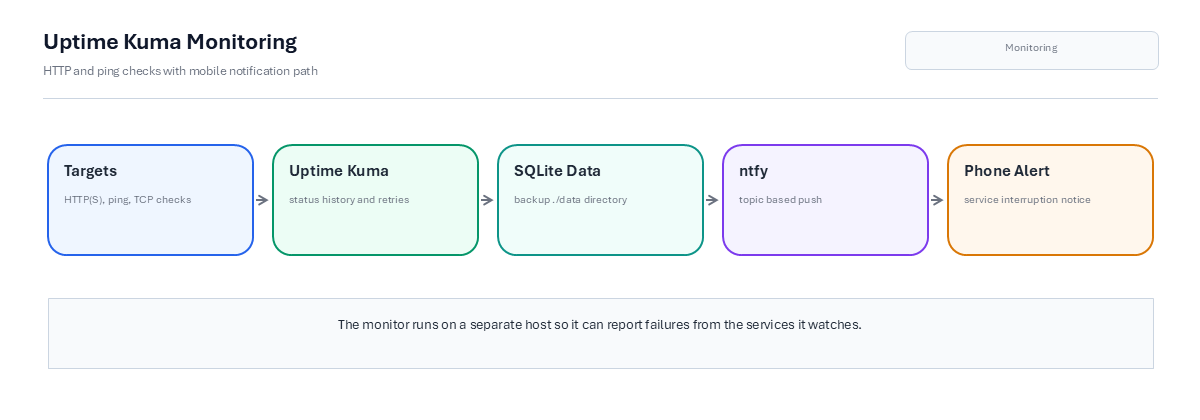
HTTP(S)와 ping 대상을 한 화면에 모아 어느 구간이 죽었는지 바로 보이게 했다.
무엇을 지켜볼까
웹 UI에서 모니터를 추가한다. 종류가 여럿이지만 두 가지로 충분했다.
- HTTP(S) — 리버스 프록시 뒤에 붙은 서비스들. URL을 찔러 200이 떨어지는지 본다.
- 핑(Ping) — 다른 홈서버 호스트가 살아 있는지 ICMP로 확인한다.
프록시 자체, DNS 차단기, RSS 리더, 관리 콘솔, 옆 호스트 핑까지 여덟 개쯤 등록했다. 확인 간격은 60초로 뒀다. 상용도 아니고 집에서 돌리는 거라 더 자주 찌를 이유는 없다.
알림은 ntfy로
Uptime Kuma가 장애를 감지하면 ntfy를 통해 휴대전화로 알림을 전송한다. 셀프호스팅한 ntfy 서버에 알림용 topic을 만들고 Uptime Kuma에 해당 URL을 등록했다. 개인용 환경에서는 별도 협업 도구 없이 간단한 HTTP 요청으로 연동할 수 있다는 점이 적합했다.
운영 후 달라진 점
모니터링을 적용한 뒤에는 상태 확인을 위해 대시보드에 반복 접속하는 일이 줄었다. 장애와 복구 알림이 오지 않는 동안에는 마지막 점검 상태가 유지되는 것으로 판단할 수 있고, 문제가 발생하면 ntfy 알림에서 대상 서비스와 시각을 확인한다.
참고