우리 팀은 작년부터 글로벌 앱마켓 서비스를 VM 기반에서 Azure Kubernetes Service(AKS)로 옮겨 왔다. 준비에 9개월, 실제 전환에 8개월이 걸렸고, 그 사이에 전면 장애도 한 번 겪었다. 결과만 놓고 보면 "k8s로 옮겼다"라는 한 줄이지만 정작 기억에 남는 건 그 과정에서 내린 결정과 실패라 따로 정리해 둔다.
왜 옮겼나
기존 글로벌 서비스는 VM(Scale Set) 위에서 이미지 중심으로 운영하고 있었다. 서비스마다 Application Gateway를 따로 두었고, 배포는 Jenkins로 VM 이미지를 만들어 올리는 방식이라 한 번 배포하는 데 수십 분이 걸렸다. 리소스도 서비스 단위로 넉넉하게 잡아 두다 보니 과할당이 많았다.
목표는 세 가지였다.
- 비용 효율화 — 과할당된 VM을 오토스케일로 정리
- 운영 안정성·확장성 — 무중단 업그레이드, 표준화된 배포 모델
- 개발 생산성 — 배포 자동화와 롤백 간소화
시작할 때 팀에는 Docker나 k8s 운영 경험이 거의 없었다. 그래서 본 전환에 앞서 9개월을 프로토타이핑과 역량 확보에 썼다. Standalone 컨테이너로 서비스를 띄워 보고 배포 파이프라인을 검증했으며, Pod 스펙을 산정하고 거버넌스 체계도 미리 세워 두었다. 이 준비 기간이 없었다면 전환은 훨씬 크게 흔들렸을 것이다.
운영 도구부터 깔았다
서비스를 옮기기 전에 클러스터를 운영할 도구부터 구축했다.
- Argo Workflows / Argo CD — CI 워크플로우 자동화와 GitOps 배포
- Harbor — 컨테이너 이미지 프라이빗 저장소
- Nexus — 내/외부 라이브러리 저장소
- SonarQube — 코드 품질·보안 정적 분석
- Kiali / Jaeger — 서비스 메시 트래픽 시각화, 분산 트레이싱
- Whatap — 클러스터 성능 모니터링
나는 이 중 CI/CD 쪽, 특히 전사가 공유하는 표준 빌드 파이프라인을 Argo Workflows로 설계하는 일을 맡았다. 빌드, 정적분석, 멀티아키텍처 이미지 빌드(Kaniko), 서명(Cosign), 배포(Argo CD)를 하나의 템플릿으로 묶었다. 그 결과 평균 빌드 시간이 Jenkins 766초(약 12분 46초)에서 Argo 400초(약 6분 40초)로 절반 가까이 줄었다.
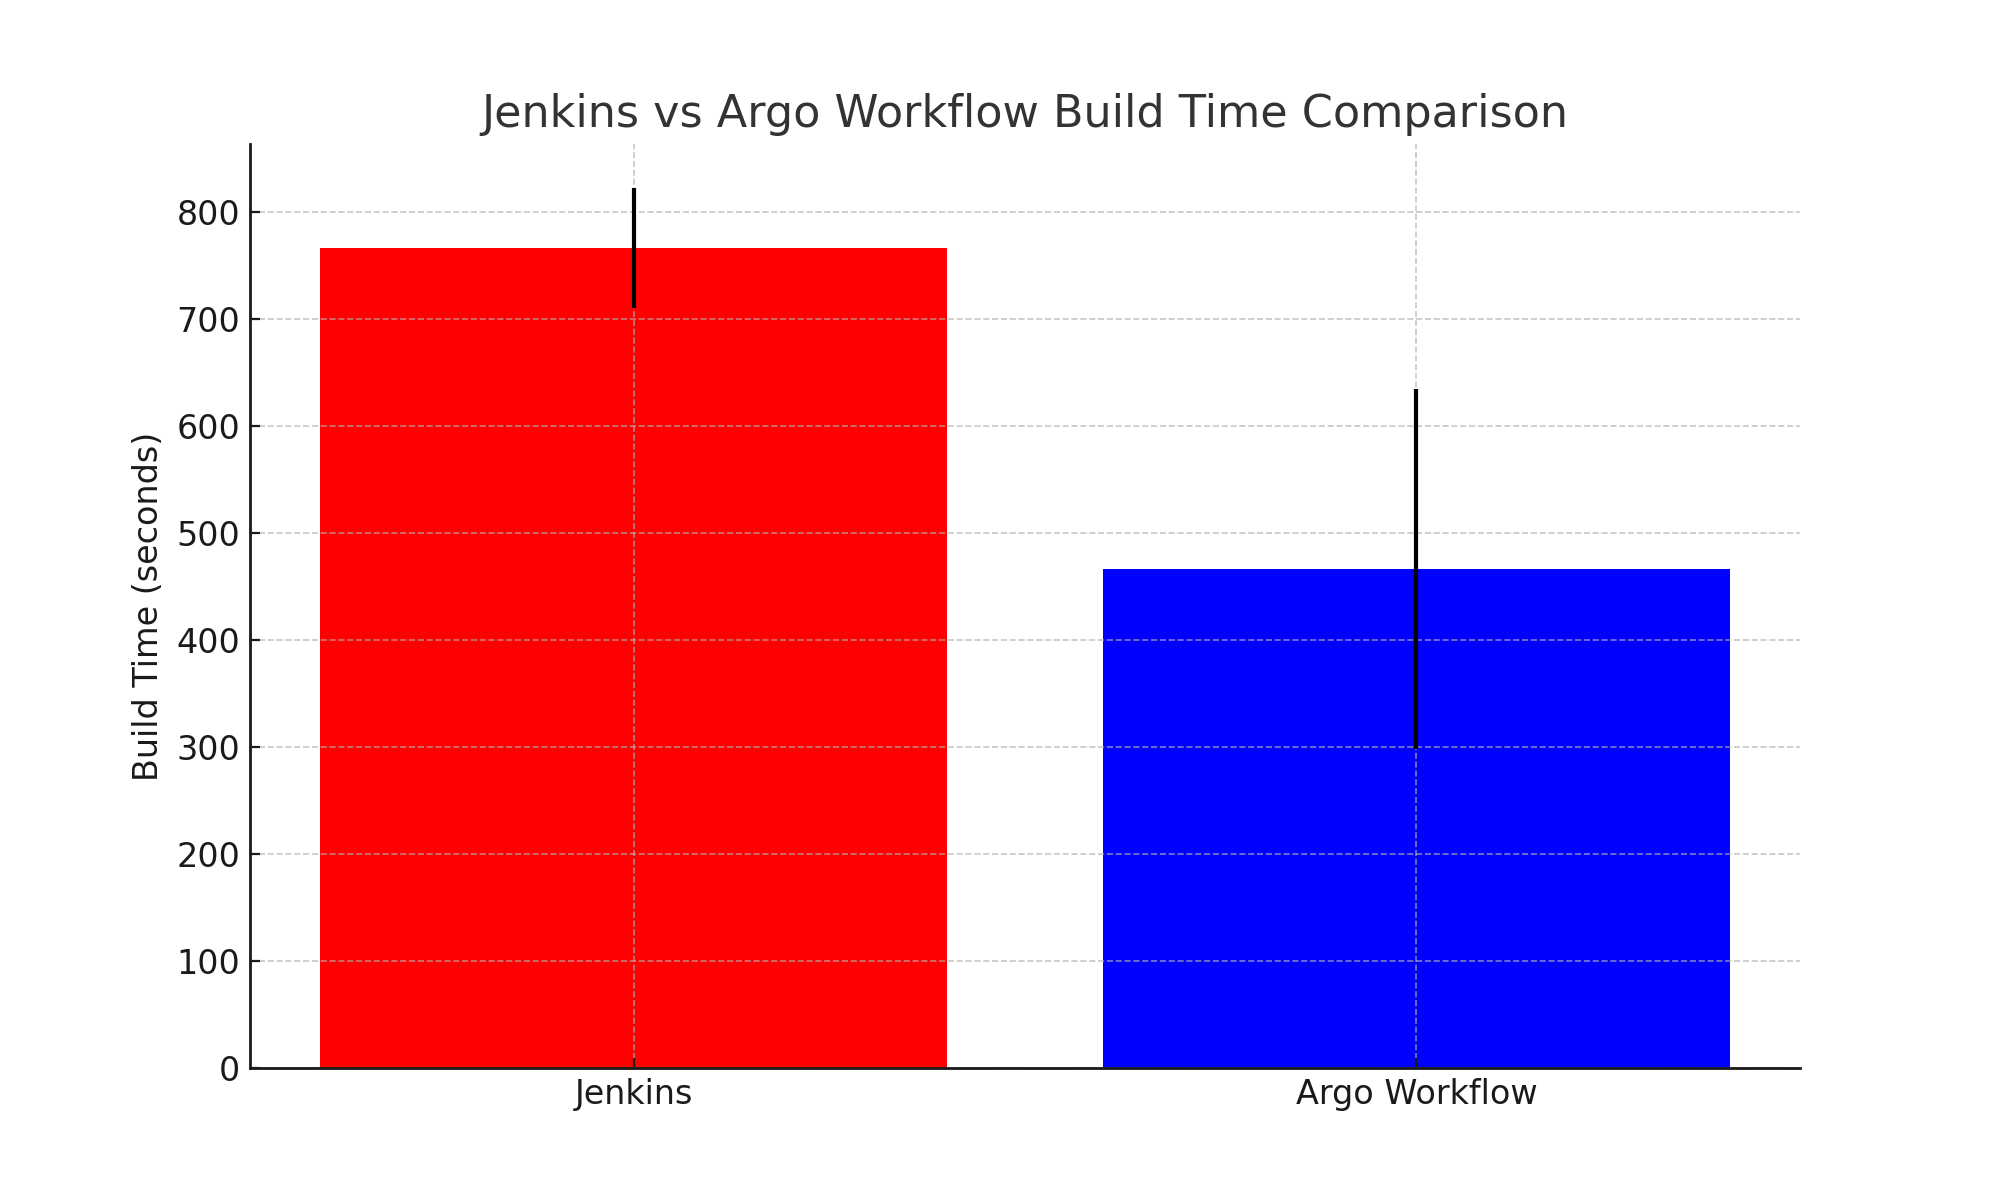
Jenkins와 Argo Workflow의 빌드 시간 비교(편차 포함).
거버넌스를 먼저, 그다음에 전환
가장 신경 쓴 부분은 "누가 무엇을 잘못 배포하더라도 클러스터는 망가지지 않게" 하는 것이었다. 이를 위해 Kyverno로 정책을 강제했다.
- 서명되지 않은 이미지는 배포 금지
- 클러스터 리소스 임의 수정 방지
- 운영용 라벨 임의 지정 방지
- 기본 NetworkPolicy 자동 반영
APM(Jennifer)은 VM 시절처럼 개별 설치하는 대신 Mutating Admission Webhook으로 Pod에 자동 주입되도록 했다. 신규 워크로드에는 기본적으로 APM 설정이 적용되며, 주입 여부는 배포 후 확인한다. 이 Webhook은 직접 구현했고, 기존 APM 제품은 유지하면서 적용 방식만 자동화한다는 원칙으로 운영팀과 협의했다.
차수별 전환과 실패 범위 제한
58개 서비스를 한 번에 옮기지 않고 차수를 나눠 전환했다. 이 결정 덕분에 장애가 났을 때도 서비스 전체가 아니라 일부만 영향을 받았다.
| 차수 | 시점 | 결과 |
|---|---|---|
| 1차 | '25.03 | 17개 전환 성공 |
| — | '25.03 말 | 포트 중복으로 전면 장애 → 롤백 |
| 2차 | '25.04 | 장애 여파로 작업 취소 |
| 3차 | '25.05 | 18개 중 12개 성공, 6개 실패(세션 유실) |
| 3.5차 | '25.05 | 실패분 6개 재전환 성공 |
| 4차 | '25.06 | 13개 전환 성공 |
| 5차 | '25.06 | 10개 중 7개 성공, 3개 실패(메시지 큐 연동 오류) |
| 5.5차 | '25.06 | 실패분 3개 재전환 성공 |
가장 큰 장애는 캐시 서버 포트가 클러스터 안에서 중복되면서 발생했다. 관리자 서비스 묶음은 전환 후 세션이 유실됐고, 일부 서비스는 메시지 큐 연동 오류로 구동에 실패했다. 공통점은 VM에서 암묵적으로 성립하던 전제가 컨테이너 환경에서는 더 이상 유효하지 않았다는 것이다. 한 번에 옮겼다면 원인을 격리하는 데만 며칠이 걸렸을 수 있지만, 차수를 나눠 둔 덕분에 실패한 서비스만 다음 차수에서 다시 시도할 수 있었다.
VM과 AKS, 무엇이 달라졌나
| 구분 | 기존 VM | AKS 전환 후 |
|---|---|---|
| 배포 | Jenkins + VM 이미지(수십 분) | Argo Workflows + Argo CD GitOps |
| 서비스 메시 | 없음 | Istio (mTLS·Canary·헤더 기반 라우팅) |
| 트래픽/WAF | Azure CDN + App Gateway | Cloudflare CDN/WAF + Istio Gateway |
| 정책 통제 | 없음 | Kyverno (이미지·리소스·라벨 강제) |
| APM | VM 내 직접 설치 | Mutating Webhook으로 Pod 자동 주입 |
| 백업/복구 | VM 이미지 수동 복원 | Velero 리소스 단위 백업·DR |
| 보안 | 수동 인증서·Key 배포 | Key Vault CSI + AAD RBAC + Istio TLS |
비용은 얼마나 줄었나
가장 자주 받는 질문이다. 이중화 운영 대비 월 비용 기준으로 정리하면 다음과 같다.
- 전체: 약 -30% (상용만 보면 -38.5%)
- Application Gateway: -78.6% (서비스마다 두던 것을 통합)
- Virtual Machine: -52.6% (오토스케일·다운사이징)
- Storage: -20.1%
App Gateway 절감폭이 가장 컸다. VM 시절에는 서비스마다 L7과 WAF를 따로 뒀는데, 이를 Istio Gateway와 Cloudflare로 통합하면서 비용 구조 자체가 단순해졌기 때문이다.
돌아보며
전환을 마치고 나니 결과 수치보다 두 가지 습관이 남았다.
첫째는 준비 기간을 아끼지 않은 것이다. 9개월의 프로토타이핑이 당시엔 지루해 보였지만, 거버넌스와 표준 템플릿을 먼저 만들어 둔 덕분에 본 전환에서 같은 실수를 반복하지 않았다.
둘째는 점진적 전환과 롤백 경로를 확보해 둔 것이다. 전면 장애가 났을 때 전체가 아니라 이번 차수만 되돌리면 됐다는 점이 가장 큰 안전장치였다.
k8s 전환에는 정답이 하나만 있는 게 아니라 팀의 성숙도와 서비스 특성에 맞춰 속도를 정하는 일이라고 생각한다. 우리도 모든 걸 잘한 건 아니었던 만큼, 비슷한 전환을 준비하는 사람에게 이 기록이 작은 참고가 되면 좋겠다.
참고