홈서버에서 각각 실행하던 STT, LLM과 TTS를 하나의 음성 대화 흐름으로 연결했다. "헤이 오비서"라는 호출어를 인식하면 뒤따르는 질문을 처리하고 합성 음성으로 답한다.
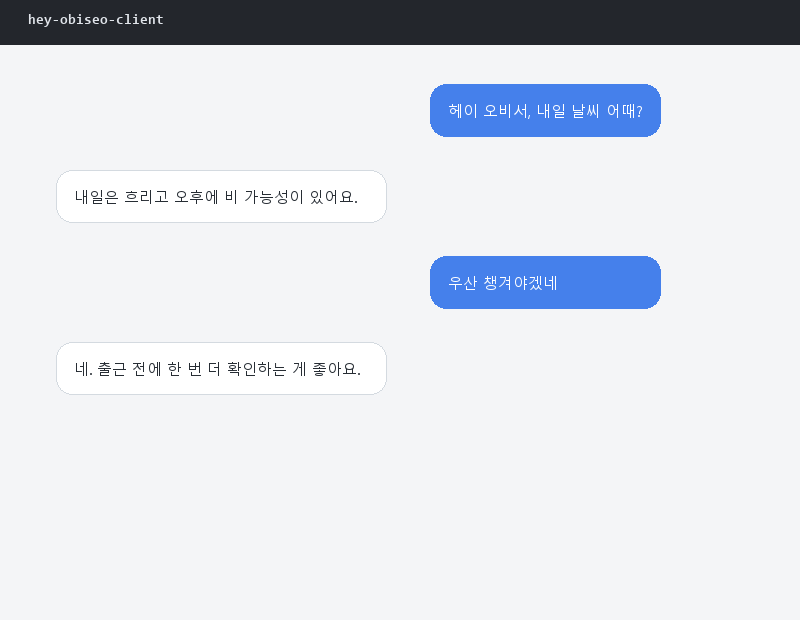
실제로 주고받은 대화. 음성으로 묻고, 내 목소리로 클로닝된 답이 돌아온다.
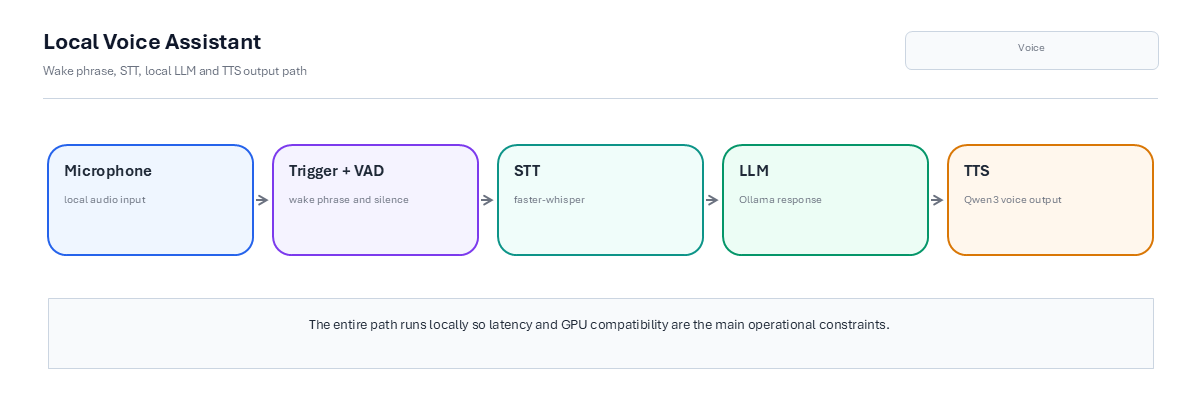
마이크 입력에서 트리거를 감지한 뒤 STT, LLM, TTS를 거쳐 스피커로 출력한다.
구조는 간단하다. 에너지 기반 VAD가 마이크 입력에서 음성이 이어지는 구간을 하나의 요청으로 묶고, faster-whisper가 이를 텍스트로 변환한다. 호출어가 감지되면 뒤따르는 내용을 질문으로 전달하고, LLM의 답변을 TTS로 합성해 스피커로 재생한다. 대화 맥락은 최근 12턴까지 유지한다. 각 구성요소는 익숙했지만 하나의 음성 대화 흐름으로 연결하자 예상하지 못한 문제가 드러났다.
호출어는 인식 편차를 고려했다
Whisper는 "오비서"를 매번 똑같이 받아쓰지는 않는다. "오비셔", "오 비서", 때로는 "어 비서"로 인식한다. 처음에는 호출어 패턴을 정확히 일치시켰지만 실제 호출의 절반가량을 놓쳤다. 이후 자주 관찰된 변형을 허용하도록 조건을 완화했다.
WAKE = re.compile(r"오\s*비\s*[서셔]|헤\s*이\s*오")
잘못 반응하는 경우가 다소 늘더라도 호출을 놓치는 것보다는 나았다. 실제 사용 빈도와 오탐 횟수를 비교해 이 기준을 유지했다.
WSL 마이크 연결 문제와 역할 분리
처음에는 GPU가 장착된 PC의 WSL에서 클라이언트를 실행하려 했다. 그러나 WSL에서 Windows 마이크를 안정적으로 사용할 수 없었다. PulseAudio RDP 소스 연결도 Connection failure: Timeout으로 끝났다. 여러 방법을 확인한 뒤 오디오 입출력만 Windows 네이티브 Python 클라이언트가 담당하도록 구성을 바꿨다. STT·LLM·TTS처럼 연산량이 큰 작업은 홈서버가 처리한다. 역할을 분리하니 오디오 장치 문제와 모델 실행 환경을 독립적으로 관리할 수 있었다.
후속 질문까지 음성으로 읽는 문제
답변 재생 후 TTS가 추가 문장을 두세 차례 더 읽는 문제가 있었다. Open WebUI의 후속 질문 추천 기능이 답변 뒤에 추천 질문 세 개를 추가했고, TTS가 이를 본문과 함께 처리한 것이 원인이었다. 음성 대화 경로에서는 해당 기능을 비활성화했다.
모델이 추론 과정(thinking)을 출력하면 TTS가 해당 내용까지 모두 읽었다. 화면에서는 참고할 수 있는 정보지만 음성 대화에서는 답변이 지나치게 길어지고 핵심을 파악하기 어려웠다. 음성 대화용 시스템 프롬프트를 별도로 작성해 답변을 1~3문장으로 제한하고, 추론 과정·불릿·마크다운을 출력하지 않도록 했다. 모델 설정에서도 thinking 출력을 비활성화했다. 음성 인터페이스에서는 짧고 구어에 가까운 답변이 훨씬 자연스러웠다.
남은 음성 합성 한계
아직 해결하지 못한 부분도 있다. TTS가 신음·추임새·의성어를 문맥에 맞는 소리가 아니라 글자 단위로 읽는 경우가 있다. 예를 들어 "흐흐"를 자연스럽게 이어 읽지 않고 "흐, 흐"처럼 분리해 발음한다. 감정이 담긴 참조 음성을 사용하면 다소 개선되지만 완전히 해결되지는 않았다. 현재는 모델의 표현력 한계로 보고, 감정 토큰과 같은 제어 기능이 지원되면 다시 검토할 예정이다.
버전 호환성을 맞추는 데 예상보다 오랜 시간이 걸렸지만, 이제는 "헤이 오비서, 내일 날씨"와 같은 질문을 음성으로 주고받을 수 있다. 요청부터 응답 합성까지 외부 클라우드를 거치지 않고 집 안의 장비에서 처리된다는 점이 이 구성의 가장 분명한 결과다.
스마트홈 제어와 연결하려면 호출어 오탐이 실제 기기 동작으로 이어지지 않도록 확인 응답, 권한 분리와 명령별 안전장치를 먼저 설계해야 한다.
참고