STT 구성은 비교적 빠르게 마쳤지만 음성 복제 TTS는 모델·CUDA·Flash Attention 버전과 참조 음성 조건을 맞추는 데 약 일주일이 걸렸다.
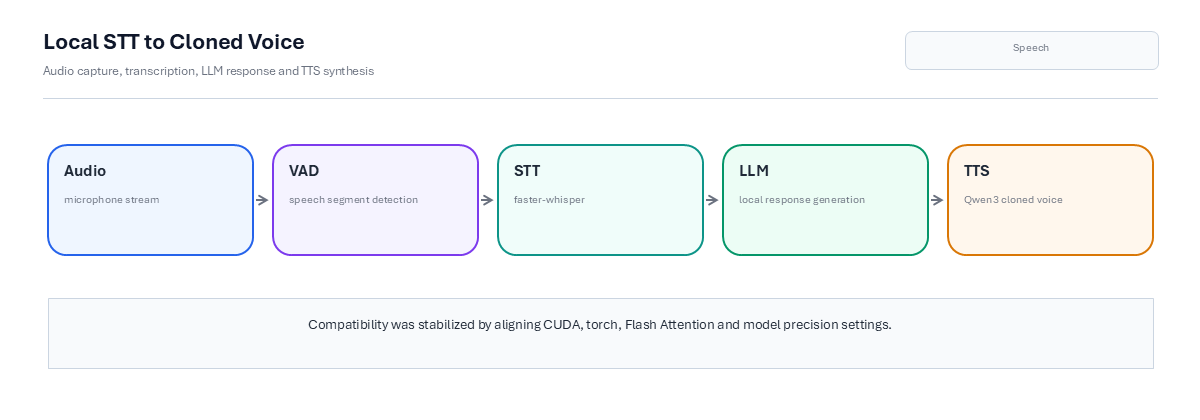
마이크 입력을 VAD로 분리한 뒤 faster-whisper, LLM, Qwen3-TTS를 거쳐 로컬 음성으로 출력한다.
faster-whisper 구성
faster-whisper 설치와 실행 절차는 복잡하지 않았다. 다만 기본값인 float16 연산이 Maxwell GPU와 맞지 않아 첫 실행에서 오류가 발생했다. compute type을 int8_float32로 변경한 뒤 정상적으로 동작했다.
WHISPER__INFERENCE_DEVICE=cuda
WHISPER__COMPUTE_TYPE=int8_float32
WHISPER__MODEL=Systran/faster-whisper-large-v3
large-v3는 한국어 음성을 충분한 정확도로 변환했고, 8초 분량의 음성을 약 0.4초에 처리했다. STT 구간까지는 큰 문제가 없었다.
사용 중에는 음성이 없는데도 "감사합니다" 같은 문장이 생성되는 현상이 나타났다. 키보드 소리나 무음 구간을 음성으로 해석해 학습 데이터에서 자주 등장한 문구를 출력한 것으로 보였다. VAD 필터로 무음과 잡음을 먼저 제거하자 같은 현상이 크게 줄었다.
GPT-SoVITS 구성과 호환성 문제
처음에는 Edge TTS를 사용했지만 원하는 음색을 선택하기 어려워 음성 복제를 지원하는 GPT-SoVITS를 검토했다.
처음 선택한 Docker 이미지는 이전 v1 기반으로 한국어 dict_language를 포함하지 않았다. v2 weights를 포함한 이미지로 변경했다.
그다음은 CUDA였다. 요즘 이미지는 대부분 cu126과 cu128로 빌드돼 있는데 우리 드라이버(550)는 cu124까지밖에 지원하지 않았다. 컨테이너 안에서 torch를 cu124로 맞추니 이번에는 flash-attn ABI가 맞지 않는 문제가 발생했다.
undefined symbol: _ZN3c104cuda29c10_cuda_check_implementationEi
호환되지 않는 flash-attn을 제거하자 API가 기동됐다. 이어서 모델 경로가 설정과 일치하지 않는 문제가 확인돼 심볼릭 링크로 경로를 맞췄다. 서로 독립적인 호환성 문제와 경로 문제가 연달아 나타나 원인별로 나눠 확인해야 했다.
API가 기동된 뒤에는 HTTP 200 응답과 함께 0바이트 파일이 반환됐다. 로그를 확인하니 모델이 기본 v1 weights로 fallback했고 레퍼런스 오디오 경로도 찾지 못하고 있었다. v2ProPlus weights와 레퍼런스 오디오 경로를 명시한 뒤 정상적으로 음성이 생성됐다.
참조 음성과 전사문 일치
처음 생성된 결과는 사람의 말로 알아듣기 어려운 소리에 가까웠다. 원인은 참조 음성에 연결한 전사문이었다. 임시로 입력한 "안녕하세요"가 실제 음성 내용과 달라 모델의 정렬이 무너졌다. 전사문을 실제 발음 내용과 일치시키자 알아듣기 어려운 소리는 사라졌다.
이후에도 높은 음역의 잡음이 섞이고 결과의 품질이 일정하지 않았다. 여러 생성 파라미터를 조정했지만 참조 음성과의 차이가 충분히 줄지 않았다. 추가 조정보다 모델 교체가 낫다고 판단했다.
Qwen3-TTS로 전환
클로닝에 쓴 8초짜리 레퍼런스. 이 목소리를 모델이 따라 만든다.
Qwen3-TTS는 RTX 4070 Ti가 장착된 다른 PC에서 실행했다. bf16과 Flash Attention을 적용했을 때 실시간에 가까운 생성 속도를 확인했지만, 패키지 설치와 생성 길이 기본값을 추가로 조정해야 했다.
먼저 flash-attn을 pip로 설치하려고 하니 av 빌드 과정에서 metadata-generation-failed가 발생했다. 소스 빌드는 포기하고 GitHub 릴리스의 prebuilt wheel을 직접 받아서 설치했다. 그리고 bf16이나 fp16으로 실행하면 torch.multinomial에서 NaN이 발생했는데, flash-attn을 맞춰 설치하고 나니 함께 해결됐다.
긴 문장이 중간에 종료되는 원인은 talker의 max_length 기본값이 20으로 설정돼 있었기 때문이다. 생성 길이 제한을 다음과 같이 변경했다.
model.model.talker.generation_config.max_new_tokens = 4096
model.model.talker.generation_config.max_length = None
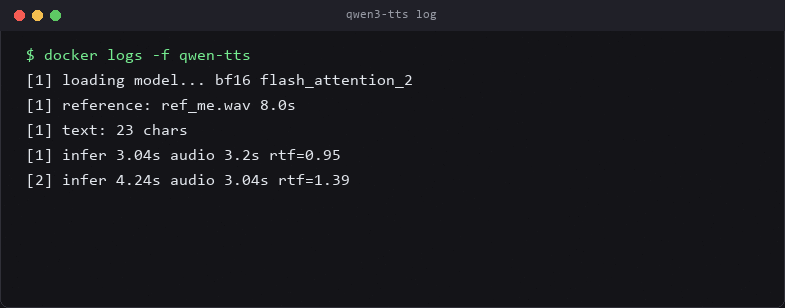
워밍업 후 23자 문장을 약 3초에 생성한 로그.
레퍼런스 길이도 영향이 컸다. 처음에 17초짜리를 넣었더니 출력이 부풀고 앞에 유령 음성이 붙었다. 8초로 줄이고 x_vector_only 모드로 두니까 시작 부분 누수도 사라졌다.
OpenVoice 음색 변환 비교
감정 표현을 보완하기 위해 OpenVoice 음색 변환 단계를 추가로 시험했다. 그러나 참조 음색과의 유사도가 오히려 낮아져 해당 단계는 제거했다. 처리 단계를 늘리는 것이 항상 품질 향상으로 이어지지는 않았다.
정리
구형 GPU에서 최신 모델을 실행하려면 Flash Attention, compute type, PyTorch의 CUDA 버전과 모델 내부 기본값을 함께 확인해야 했다. 이번 구성에서는 오류를 패키지 호환성, 모델 경로, 참조 음성과 생성 길이 설정으로 나눠 확인하면서 재현 가능한 점검 순서를 정리할 수 있었다.
참고